
4.8 并行计算
从 20 世纪 70 年代到 2000 年代中期,单个处理器核心的速度一直呈指数级增长。这种提速很大程度上靠提高时钟频率(clock frequency)实现,也就是处理器执行基本操作的速率。然而到了 2000 年代中期,受功耗和散热的限制,这种指数增长戛然而止;此后,单个处理器核心的速度增长慢了许多。于是,CPU 厂商转而开始在单个处理器里放进多个核心,让更多操作得以并发执行。
并行(parallelism)并不是新概念。大规模并行计算机已经用了几十年,主要用于科学计算和数据分析。即便在只有一个处理器核心的个人计算机上,操作系统和解释器也提供了并发的抽象。做法是上下文切换(context switching),也就是在不同任务之间快速切换,不等某个任务结束。因此,哪怕一台机器只有一个处理核心,多个程序也能在同一台机器上并发运行。
面对处理器核心数量不断增多的趋势,应用程序为了跑得更快,现在必须利用并行。在单个程序内部,必须把计算安排好,让尽可能多的工作能并行完成。但是,并行给编写正确的代码带来了新挑战,尤其是存在共享可变状态(shared mutable state)的时候。
有些问题能在函数式模型里高效解决,没有共享可变状态,并行几乎不成问题。纯函数具有引用透明性(referential transparency),也就是说,把表达式替换成它的值,或者反过来,都不会改变程序的行为。这样一来,互不依赖的表达式就能并行求值。正如前一节所说,MapReduce 框架让程序员只需极少的工作量,就能指定并并行运行函数式程序。
可惜,并非所有问题都能用函数式编程高效解决。Berkeley View 项目在科学与工程领域找出了十三种常见计算模式,其中只有一种是 MapReduce。其余模式都需要共享状态。
接下来,我们会看到可变共享状态怎样给并行程序引入 bug,以及多种防止这类 bug 的方法。我们会在两个应用里研究这些技术:一个网络爬虫(crawler)和一个粒子模拟器(simulator)。
4.8.1 Python 中的并行
在深入并行的细节之前,先看看 Python 对并行计算的支持。Python 提供两种并行执行方式:线程(threading)和多进程(multiprocessing)。
线程。使用线程时,同一个解释器里会存在多个执行「线程」。每个线程独立于其他线程执行代码,但它们共享同一份数据。不过,CPython 解释器是 Python 的主要实现,一次只解释一个线程的代码,靠在线程之间切换来制造并行的假象。另一方面,解释器之外的操作(比如写文件或访问网络)可以真正并行。
threading 模块里有用于创建和同步线程的类。下面是一个简单的多线程程序:
>>> import threading
>>> def thread_hello():
     other = threading.Thread(target=thread_say_hello, args=())
     other.start()
     thread_say_hello()

>>> def thread_say_hello():
     print('hello from', threading.current_thread().name)

>>> thread_hello()
hello from Thread-1
hello from MainThread
Thread 构造函数会新建一个线程,需要指定新线程要运行的目标函数,以及传给该函数的参数。在 Thread 对象上调用 start,表示它已经准备好运行。current_thread 函数返回与当前执行线程关联的 Thread 对象。
这个例子里,两次打印的顺序可以是任意的,因为我们没有对它们做任何同步。
多进程。Python 也支持多进程,程序可以生成多个解释器,也就是进程(process),每个进程都能独立运行代码。进程之间通常不共享数据,所以任何共享状态都必须靠进程间通信来传递。另一方面,进程会按底层操作系统和硬件提供的并行度真正并行执行。所以,只要 CPU 有多个处理器核心,Python 进程就能真正并发运行。
multiprocessing 模块里有创建和同步进程的类。下面是改用进程的 hello 示例:
>>> import multiprocessing
>>> def process_hello():
     other = multiprocessing.Process(target=process_say_hello, args=())
     other.start()
     process_say_hello()

>>> def process_say_hello():
     print('hello from', multiprocessing.current_process().name)

>>> process_hello()
hello from MainProcess
>>> hello from Process-1正如这个例子所示,multiprocessing 里的许多类和函数与 threading 中的类似。这个例子还说明,缺少同步会影响共享状态——因为屏幕输出本身也可以看作共享状态。这里,交互式进程的解释器提示符出现在了另一个进程的打印输出之前。
4.8.2 共享状态的问题
为了进一步说明共享状态的问题,来看一个简单的例子:一个计数器由两个线程共享:
import threading
from time import sleep

counter = [0]

def increment():
    count = counter[0]
    sleep(0) # try to force a switch to the other thread
    counter[0] = count + 1

other = threading.Thread(target=increment, args=())
other.start()
increment()
print('count is now: ', counter[0])
这个程序里,两个线程试图把同一个计数器加一。CPython 解释器几乎可以在任何时候在线程之间切换。只有最基本的操作才是原子(atomic)的,也就是说它们看起来瞬间完成,求值或执行期间不可能发生切换。把计数器加一需要多个基本操作:读取旧值、给它加一、写入新值。解释器可以在其中任意两个操作之间切换线程。
为了展示解释器在错误的时间切换线程会怎样,我们试着用休眠 0 秒来强制切换。运行这段代码时,解释器往往会在调用 sleep 时切换线程。这可能产生下面这样的操作顺序:
Thread 0                    Thread 1
read counter[0]: 0
                            read counter[0]: 0
calculate 0 + 1: 1
write 1 -> counter[0]
                            calculate 0 + 1: 1
                            write 1 -> counter[0]
最终计数器的值是 1,尽管它被加了两次!更糟的是,解释器很少在错误的时间切换,这让调试变得很困难。即便调用了 sleep,这个程序有时得到正确的结果 2,有时得到错误的结果 1。
只有在共享数据可能被一个线程修改、同时又被另一个线程访问时,才会出现这个问题。这种冲突称为竞争条件(race condition),是只在并行世界里才会出现的 bug。
为了避免竞争条件,对于可能被多个线程修改和访问的共享数据,必须保护它免受并发访问。比如,只要能保证线程 1 在线程 0 访问完计数器之后才访问它(反过来也一样),就能保证算出正确的结果。如果共享数据受到保护、不会被并发访问,我们就说它是同步(synchronization)的。接下来几节会介绍多种提供同步的机制。
4.8.3 不需要同步的时候
有些情况下,只要并发访问不会导致错误行为,对共享数据的访问就不需要同步。最简单的例子是只读数据。这类数据永远不会被修改,所以无论线程什么时候访问,读到的值都一样。
极少数情况下,会被修改的共享数据也可能不需要同步。但要判断什么时候适用,需要深入了解解释器以及底层软硬件的工作方式。看下面这个例子:
items = []
flag = []

def consume():
    while not flag:
        pass
    print('items is', items)

def produce():
    consumer = threading.Thread(target=consume, args=())
    consumer.start()
    for i in range(10):
        items.append(i)
    flag.append('go')

produce()
这里,生产者线程往 items 里添加条目,消费者则一直等到 flag 非空。生产者添加完条目后,会往 flag 里加一个元素,让消费者可以继续。
在大多数 Python 实现中,这个例子都能正常工作。但在其他编译器、解释器乃至硬件上,有一种常见的优化:重排单个线程内彼此不依赖数据的操作。在这样的系统里,flag.append('go') 这条语句可能被移到循环之前,因为两者在数据上互不依赖。一般来说,除非你确定底层系统不会重排相关操作,否则应避免这种写法。
4.8.4 同步的数据结构
同步共享数据最简单的方法,是使用自带同步操作的数据结构。queue 模块里有一个 Queue 类,提供同步的先进先出(FIFO)访问。put 方法往 Queue 里添加条目,get 方法取出一条。Queue 类本身保证这些方法是同步的,因此无论线程操作怎样交错,条目都不会丢失。下面是一个使用 Queue 的生产者/消费者示例:
from queue import Queue

queue = Queue()

def synchronized_consume():
    while True:
        print('got an item:', queue.get())
        queue.task_done()

def synchronized_produce():
    consumer = threading.Thread(target=synchronized_consume, args=())
    consumer.daemon = True
    consumer.start()
    for i in range(10):
        queue.put(i)
    queue.join()

synchronized_produce()
除了改用 Queue 和 get、put 调用,这段代码还有几处改动。我们把消费者线程标为守护线程(daemon),也就是程序退出时不会等这个线程结束。这样消费者里就可以用无限循环。不过,我们仍要保证主线程会退出,而且是在队列里的条目全部被消费之后才退出。消费者调用 task_done 方法,告诉 Queue 自己已经处理完一个条目;主线程调用 join 方法,等到所有条目都处理完,从而保证程序在这之后才退出。
一个更复杂的 Queue 用例是并行网络爬虫,它搜索网站上的死链接(dead link)。这个爬虫会跟踪同一站点托管的所有链接,因此要处理大量 URL,不断把新 URL 加进 Queue,再把待处理的 URL 取出来。借助同步的 Queue,多个线程可以安全地同时往这个数据结构里添加和取出。
4.8.5 锁
当某个数据结构没有现成的同步版本时,我们就得自己提供同步。锁(lock)就是做到这一点的基本机制。一把锁最多只能被一个线程获取;在获取它的线程释放之前,其他线程都无法获取。
在 Python 中,threading 模块有一个提供锁定功能的 Lock 类。Lock 有 acquire 和 release 两个方法,分别用来获取和释放锁;这个类保证同一时刻只有一个线程能获取它。锁已被持有时,其他想获取它的线程都会被迫等待,直到锁被释放。
要让一把锁保护某组数据,所有线程都得遵守一条规则:只要没有持有那把锁,任何线程都不能访问这些共享数据。实际上,所有线程都要把对共享数据的操作「包」在获取和释放锁的调用里。
在并行网络爬虫里,用一个集合记录任何线程遇到过的所有 URL,避免同一个 URL 被处理多次(否则可能陷入循环)。但是 Python 没有同步的集合,所以我们只能用锁来保护对普通集合的访问:
seen = set()
seen_lock = threading.Lock()

def already_seen(item):
    seen_lock.acquire()
    result = True
    if item not in seen:
        seen.add(item)
        result = False
    seen_lock.release()
    return result
这里需要一把锁,防止在「检查 URL 是否在集合中」和「把它加进集合」之间,另一个线程抢先把它加进去。此外,往集合里添加不是原子操作,因此并发添加可能破坏集合的内部数据。
在这段代码里,我们必须小心,等到释放锁之后再返回。一般来说,必须在不再需要锁时及时释放它。这很容易出错,尤其是有异常的时候;为此 Python 提供了 with 复合语句,帮我们获取和释放锁:
def already_seen(item):
    with seen_lock:
        if item not in seen:
            seen.add(item)
            return False
        return True
with 语句保证在执行它的语句块之前获取 seen_lock,并且在因任何原因退出语句块时释放它。(with 语句其实也能用于锁定以外的操作,这里不展开。)
必须相互同步的操作,要用同一把锁。而两组互不相交、只需各自内部同步的操作,则应该用两个不同的锁对象,以免过度同步。
4.8.6 屏障
避免共享数据访问冲突的另一种方法,是把程序划分成多个阶段,保证共享数据只在没有其他线程访问的阶段里被修改。屏障(barrier)要求所有线程都先到达它,任何一个线程才能继续,从而把程序划分成多个阶段。屏障之后的代码不能与屏障之前的代码并发执行。
在 Python 中,threading 模块用 Barrier 实例的 wait 方法提供屏障:
counters = [0, 0]
barrier = threading.Barrier(2)

def count(thread_num, steps):
    for i in range(steps):
        other = counters[1 - thread_num]
        barrier.wait() # wait for reads to complete
        counters[thread_num] = other + 1
        barrier.wait() # wait for writes to complete

def threaded_count(steps):
    other = threading.Thread(target=count, args=(1, steps))
    other.start()
    count(0, steps)
    print('counters:', counters)

threaded_count(10)
这个例子里,对共享数据的读和写发生在不同阶段,由屏障隔开。写操作发生在同一阶段,但彼此不相交;这种不相交是必要的,可以避免在同一阶段并发写入同一数据。由于这段代码已正确同步,两个计数器最终总是 10。
多线程粒子模拟器也用类似方式借助屏障同步对共享数据的访问。在模拟中,每个线程拥有若干粒子,所有粒子会在许多离散时间步(timestep)里相互作用。粒子有位置、速度和加速度,每个时间步都会根据其他粒子的位置算出新的加速度。粒子的速度要相应更新,位置也要根据速度更新。
和上面的简单例子一样,有一个读阶段,所有线程读取所有粒子的位置。每个线程在这个阶段更新自己那些粒子的加速度;由于这些写操作互不相交,所以不必同步。在写阶段,每个线程更新自己那些粒子的速度和位置。同样,这些写操作互不相交,并靠屏障与读阶段隔开。
4.8.7 消息传递
最后一种避免共享数据被不当修改的机制,是完全避开对同一数据的并发访问。在 Python 里,用多进程而不是线程,自然就能做到,因为每个进程在独立的解释器中运行,有各自的数据。多个进程需要的任何状态,都可以靠进程之间传递消息来交流。
multiprocessing 模块里的 Pipe 类提供了进程间的通信通道。默认情况下它是双工的(duplex),也就是双向通道;传入参数 False 则得到单向通道。send 方法通过通道发送一个对象,recv 方法接收一个对象。后者是阻塞(blocking)的,也就是说调用 recv 的进程会一直等到收到对象为止。
下面是一个使用进程和管道的生产者/消费者示例:
def process_consume(in_pipe):
    while True:
        item = in_pipe.recv()
        if item is None:
            return
        print('got an item:', item)

def process_produce():
    pipe = multiprocessing.Pipe(False)
    consumer = multiprocessing.Process(target=process_consume, args=(pipe[0],))
    consumer.start()
    for i in range(10):
        pipe[1].send(i)
    pipe[1].send(None) # done signal

process_produce()
这个例子里,我们用 None 这条消息表示通信结束。创建消费者进程时,我们还会把管道的一端作为参数传给目标函数。这一步是必要的,因为状态必须在进程之间显式共享。
多进程版粒子模拟器用管道在每个时间步里于进程之间传递粒子位置。实际上,它用管道在进程之间搭出一条完整的环形管道,尽量减少通信。每个进程把自己那些粒子的位置注入它所在的管道阶段,这些位置最终会沿管道完整转一圈。每转一步,进程都会根据当前处于自己管道阶段的位置,把力施加到自己的粒子上;转完一整圈后,所有力就都施加到它的粒子上了。
multiprocessing 模块还为进程提供了其他同步机制,包括同步队列、锁,以及从 Python 3.3 起加入的屏障。例如,可以用锁或屏障同步屏幕打印,避免前面看到的那种错误的显示输出。
4.8.8 同步的陷阱
同步方法虽然能有效保护共享状态,但也可能被用错:没能正确同步、过度同步,或者因死锁(deadlock)导致程序挂起。
欠同步。并行计算中一个常见的坑,是没有正确同步对共享数据的访问。在集合那个例子里,我们需要把成员检查(membership check)和插入一起同步,这样别的线程就无法在这两个操作之间插入。即便这两个操作各自都同步了,没有把它们合在一起同步仍然是错的。
过度同步。另一个常见错误是把程序过度同步,导致本来不冲突的操作无法并发。举个很简单的例子,只要在线程启动时获取一把主锁、直到线程结束才释放,就能避开对共享数据的所有冲突访问。但这样会把整段代码串行化,完全没有并行。某些情况下,这甚至会让程序无限期挂起。例如,设想一个消费者/生产者程序,消费者拿到锁后从不释放。这会阻止生产者生产任何条目,反过来又让消费者无事可做,因为它没有东西可消费。
这个例子虽然简单,但实践中程序员常常会多多少少过度同步代码,导致代码无法充分利用可用的并行。
死锁。同步机制会让线程或进程相互等待,因此很容易出现死锁:两个或多个线程或进程卡住,彼此等待对方完成。我们刚看到,忘记释放锁会让线程无限期卡住。但即使线程或进程都正确释放了锁,程序仍可能陷入死锁。
死锁的根源是循环等待(circular wait),下面用进程来演示。任何进程都无法继续,因为它在等待那些正在等它完成的进程。
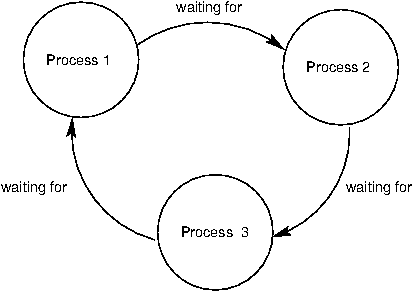
举个例子,我们来构造一个涉及两个进程的死锁。假设它们共享一条双工管道,并像下面这样尝试相互通信:
def deadlock(in_pipe, out_pipe):
    item = in_pipe.recv()
    print('got an item:', item)
    out_pipe.send(item + 1)

def create_deadlock():
    pipe = multiprocessing.Pipe()
    other = multiprocessing.Process(target=deadlock, args=(pipe[0], pipe[1]))
    other.start()
    deadlock(pipe[1], pipe[0])

create_deadlock()两个进程都先尝试接收数据。回想一下,recv 方法会阻塞,直到有数据可用。由于两个进程都没有发送任何数据,它们都会无限期地等待对方发来数据,于是形成死锁。
要避免死锁,同步操作必须正确对齐。这可能需要:先通过管道发送再接收、以相同顺序获取多把锁,以及确保所有线程都在正确的时间到达正确的屏障。
4.8.9 结论
如我们所见,并行给编写正确、高效的代码带来了新挑战。硬件层面的并行化趋势在可预见的未来仍会持续,因此并行计算在应用程序开发中会越来越重要。目前有一个非常活跃的研究领域,致力于让程序员更轻松地实现并行、减少出错的可能。我们这里的讨论,只是对这一计算机科学关键领域的基本介绍。