
2.8 效率
如何表示和处理数据,往往取决于各种方案中哪个更高效。效率指的是表示或处理数据所用的计算资源,比如算出函数结果、表示一个对象分别需要多少时间和内存。这些数量会因实现细节的不同而相差悬殊。
2.8.1 测量效率
要精确测量一个程序运行需要多久、消耗多少内存,是件很有挑战的事,因为结果取决于计算机配置的许多细节。刻画一个程序的效率,更可靠的做法是统计某个事件发生了多少次,比如函数调用的次数。
回到我们最早见过的树递归函数——用来计算斐波那契数列中数字的 fib 函数。
>>> def fib(n):
        if n == 0:
            return 0
        elif n == 1:
            return 1
        else:
            return fib(n - 2) + fib(n - 1)
>>> fib(5)
5
来考虑求值 fib(6) 时呈现出的计算模式,如下图所示。要计算 fib(5),需要计算 fib(3) 和 fib(4);而要计算 fib(3),又需要计算 fib(1) 和 fib(2)。总的来说,这个演化出的过程看起来像一棵树。每个蓝色圆点,都代表遍历这棵树时完成的一次斐波那契数计算。
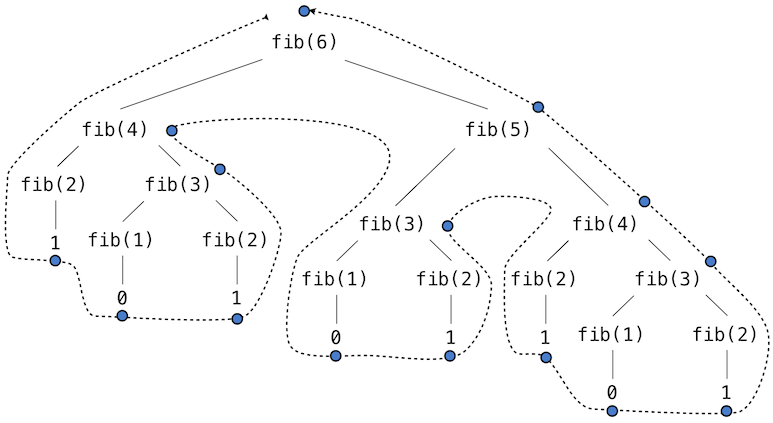
作为典型的树递归函数,它很有教学价值,但用它来算斐波那契数效率极低,因为它做了大量冗余计算。fib(3) 的整个计算过程被重复了一遍。
我们可以量一量这种低效。count 这个高阶函数返回一个与参数等效的函数,这个函数还维护一个 call_count 属性。这样就能查看 fib 到底被调用了多少次。
>>> def count(f):
        def counted(n):
            counted.call_count += 1
            return f(n)
        counted.call_count = 0
        return counted
统计 fib 的调用次数可以发现,所需的调用次数增长得比斐波那契数本身还快。这种调用次数的快速膨胀,是树递归函数的特征。
>>> fib = count(fib)
>>> fib(19)
4181
>>> fib.call_count
10946
空间。 要理解一个函数的空间需求,就得说明在计算的环境模型中,内存一般是如何使用、保留和回收的。解释器在求值表达式时,会保留所有活动的环境,以及这些环境引用的全部值和帧。如果某个环境为正在求值的表达式提供了求值上下文,它就是活动的。一旦为其创建第一个帧的那次函数调用最终返回,这个环境就变为非活动的。
例如,在求值 fib 时,解释器按前面展示的顺序逐个计算每个值,遍历这棵树。为此,在计算的任何时刻,它只需记录树中位于当前节点上方的那些节点。用来计算其他分支的内存可以回收,因为它不会影响后续计算。一般来说,树递归函数所需的空间与树的最大深度成正比。
下图展示了求值 fib(3) 时创建的环境。在求值 fib 首次应用的返回表达式时,会先求值 fib(n-2),得到值 0。这个值一旦算出来,对应的环境帧(图中标灰)就不再需要了:它已经不属于活动环境。所以,设计良好的解释器可以回收存储这个帧的内存。反过来说,如果解释器当前正在求值 fib(n-1),那么这次 fib 应用(此时 n 为 2)创建的环境就是活动的。同样,最初把 fib 施加到 3 时创建的环境也是活动的,因为它的返回值还没算出来。
count_frames 这个高阶函数跟踪 open_count,也就是函数 f 尚未返回的调用次数。max_count 属性是 open_count 曾经达到的最大值,它对应计算过程中同时处于活动状态的最大帧数。
>>> def count_frames(f):
        def counted(n):
            counted.open_count += 1
            counted.max_count = max(counted.max_count, counted.open_count)
            result = f(n)
            counted.open_count -= 1
            return result
        counted.open_count = 0
        counted.max_count = 0
        return counted
>>> fib = count_frames(fib)
>>> fib(19)
4181
>>> fib.open_count
0
>>> fib.max_count
19
>>> fib(24)
46368
>>> fib.max_count
24总结一下,fib 的空间需求(以活动帧数衡量)比输入少 1,通常很小;而时间需求(以递归调用总数衡量)比输出还大,通常极其巨大。
2.8.2 记忆化
树递归的计算过程常常可以借助记忆化(memoization)变得更高效。记忆化是一种强大的技术,能提升那些会重复计算的递归函数的效率。记忆化函数会保存先前收到过的每个参数所对应的返回值。第二次调用 fib(25) 时,它不会再递归地重新计算,而是直接返回已经算好的结果。
记忆化可以自然地表达为一个高阶函数,而这样的高阶函数也能当装饰器用。下面的定义创建了一个缓存(cache),保存先前计算过的结果,以计算时所用的参数为索引。用字典作缓存,要求被记忆化的函数的参数是不可变的。
>>> def memo(f):
        cache = {}
        def memorized(n):
            if n not in cache:
                cache[n] = f(n)
            return cache[n]
        return memorized
如果把 memo 用到斐波那契数的递归计算上,就会演化出一种新的计算模式,如下图所示。
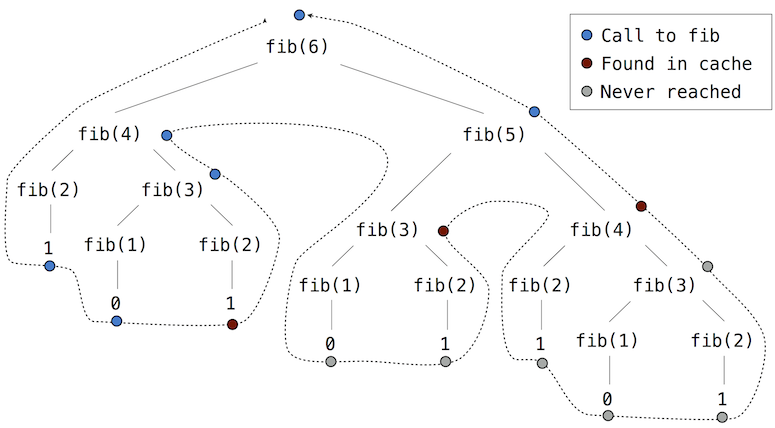
在这个 fib(5) 的计算中,算右侧分支的 fib(4) 时,会复用 fib(2) 和 fib(3) 已经算出的结果。这样一来,树递归计算中有很大一部分根本不必再做。
借助 count 函数可以看到,对于每个不同的输入,fib 实际上只会被调用一次。
>>> counted_fib = count(fib)
>>> fib =memo(count_fib)
>>> fib(19)
4181
>>> counted_fib.call_count
20
>>> fib(34)
5702887
>>> counted_fib.call_count
35
2.8.3 增长阶
正如前面的例子所示,各个计算过程消耗计算资源(时间和空间)的速率可能相差极大。然而,要准确判断调用一个函数会用掉多少空间或时间,是件非常困难的事,它取决于许多因素。分析一个计算过程的一个好办法,是把它和一组需求类似的过程归为一类。一种有用的分类方式,就是看这个过程的增长阶(order of growth),它用简单的说法表达出:过程的资源需求如何随输入变化而增长。
为了引入增长阶的概念,我们来分析下面的函数 count_factors,它统计能整除输入
求值 count_factors 需要多少时间?确切答案因计算机而异,但对于涉及的计算量,我们能得出一些有用的一般性观察。这个过程执行 while 语句体的总次数,是小于 while 语句前后的语句各执行一次。所以,执行的语句总数是 while 循环体中的语句数,while 循环外的语句数。这个公式虽不精确,但大体刻画了求值 count_factors 所需时间随输入
要得到更精确的描述就很难了。常量 count_factors 的增长阶精确地表明:计算 count_factors(n) 所需的时间以
Θ 记号。 设
如果存在与
我们就说
- 一个下界
和 - 一个上界
检查函数体,就能用这个定义证明:求值 count_factors(n) 所需的步数按
首先,取 count_factors(n) 至少需要 while 循环之外至少有 4 行执行,每行至少需要 1 步。while 循环体内至少有 2 行执行,再加上 while 头部本身,这些每行都至少需要 1 步。while 循环体至少求值
其次,来验证上界。我们假设 count_factors 函数体内的任何一行最多需要 count_factors(n) 最多需要 while 循环之外有 5 行代码,循环内有 4 行(包括 while 头部)。即使每个 if 头部都求值为 true,这个上界依然成立。最后,取
2.8.4 示例:幂运算
考虑计算某个数的幂的问题。我们想要一个函数,以底数
这个递归定义很容易改写成递归函数:
>>> def exp(b, n):
        if n == 0:
            return 1
        return b * exp(b, n - 1)
这是一个线性递归过程,需要
>>> def exp_iter(b, n):
        result = 1
        for _ in range(n):
            result = result * b
        return result
用连续平方法(successive squaring),可以用更少的步数算出幂。例如,
而是可以用三次乘法算出来:
对于指数是 2 的幂的情况,这种方法很好用。如果使用下面这条递归规则,我们也能把连续平方法用于一般情形的幂运算:
这个方法也可以写成一个递归函数:
>>> def square(x):
        return x * x

>>> def fast_exp(b, n):
        if n == 0:
            return 1
        if n % 2 == 0:
            return square(fast_exp(b, n // 2))
        else:
            return b * fast_exp(b, n - 1)

>>> fast_exp(2, 100)
1267650600228229401496703205376
fast_exp 演化出的计算过程,在空间和步数上都随 fast_exp 计算
当 fast_exp 只需要 14 次乘法,而不是 1000 次。
2.8.5 增长类别
增长阶的设计初衷,是简化计算过程的分析与比较。许多不同的过程可以有相同的增长阶,说明它们以相似的方式增长。对计算机科学家来说,认识并识别常见的增长阶、找出增长阶相同的过程,是一项重要的技能。
常数。 常数项不影响过程的增长阶。例如,
对数。 对数的底数不影响过程的增长阶。例如,
嵌套。 当一个内部过程在外部过程的每一步中都要重复执行时,整个过程的增长阶就是外部、内部过程步数的乘积。
例如,下面的函数 overlap 计算列表 a 中有多少个元素也出现在列表 b 中。
>>> def overlap(a, b):
        count = 0
        for item in a:
            if item in b:
                count += 1
        return count

>>> overlap([1, 3, 2, 2, 5, 1], [5, 4 ,2])
3
列表的 in 运算符需要 b 的长度。它被施加 a 的长度。表达式 item in b 是内部过程,for item in a 循环是外部过程。这个函数的总增长阶是
低阶项。 随着过程的输入增长,计算中增长最快的部分会主导总资源消耗。Θ 记号正捕捉了这种直觉。在一个和式中,除了增长最快的项,其余各项都可以舍去,而不改变增长阶。
例如,考虑函数 one_more,它返回列表 a 中有多少个元素比 a 中另一个元素大 1。也就是说,在列表 [3, 14, 15, 9] 中,元素 15 比 14 大 1,所以 one_more 会返回 1。
>>> def one_more(a):
        return overlap(a, [x + 1 for x in a])

>>> one_more([3, 14, 15, 9])
1
这个计算分为两部分:列表推导式和对 overlap 的调用。对于长度为 a,列表推导式需要 overlap 需要
常见的类别。 有了这些等价关系,就归纳出一小组常见类别,足以描述大多数计算过程。最常见的类别按增长从慢到快列在下面,并说明它们在输入增加时的增长情况。每一类后面都给出了例子。
| 类别 | 增长阶描述 | 例子 | |
|---|---|---|---|
| 常数 | 增长与输入无关 | abs | |
| 对数 | 输入乘以常数,资源只增加一个常量 | fast_exp | |
| 线性 | 输入递增,资源增加一个常量 | exp | |
| 二次 | 输入递增,资源增加 n | one_more | |
| 指数 | 输入递增,资源成倍增加 | fib |
除了这些,还有其他增长阶类别,比如 count_factors 的
指数增长涵盖许多不同的增长阶,因为改变底数 fib,其步数随输入
的整数,其中
我们还说过,步数与结果值成正比,所以这个树递归过程需要