
2.4 可变数据
INFO
我们已经看到,抽象对于应对大型系统的复杂性至关重要。有效的程序设计还需要组织原则,来指导我们制定程序的整体设计。特别是,我们需要一些策略,把大型系统组织成模块化(modular)的结构——也就是能自然地分成若干连贯的部分,这些部分可以各自开发和维护。
打造模块化程序的一个强大办法,是引入会随时间改变状态的数据。这样一来,单个数据对象就能代表某种独立于程序其余部分而演变的事物。变化中的对象,其行为可能受自身历史影响,就像现实世界里的实体一样。给数据加上状态,是面向对象编程(object-oriented programming)范式的核心要素。
2.4.1 对象隐喻
在本书开头,我们区分了函数和数据:函数执行操作,数据被操作。当我们把函数值也算进数据时,就等于承认数据也可以有行为。函数既能像数据一样被操作,也能被调用来完成计算。
对象(object)把数据值和行为结合在一起。对象既表示信息,行为举止也像它所代表的东西。对象如何与其他对象交互,这套逻辑和编码对象值的信息打包在一起。打印一个对象时,它知道如何把自己拼写成文本。如果一个对象由多个部分组成,它知道如何按需展示这些部分。对象既是信息也是过程,二者捆绑在一起,用来表示复杂事物的属性、交互和行为。
在 Python 中,对象的行为由一套专门的对象语法和相关术语实现,下面用例子来介绍。日期就是一种对象。
>>> from datetime import date名称 date 绑定到一个类(class)。前面说过,类代表一类值。具体的日期称为该类的实例(instance)。调用类,传入描述该实例的参数,就能构造(construct)出实例。
>>> tues = date(2014, 5, 13)虽然 tues 是用基本数字构造出来的,但它的行为像一个日期。例如,用另一个日期减去它,会得到一个时间差,我们可以把它打印出来。
>>> print(date(2014, 5, 19) - tues)
6 days, 0:00:00对象有属性(attribute),也就是对象内部一些有名字的值。和许多其他编程语言一样,Python 用点语法来指定对象的某个属性。
>>> <expression> . <name>上面,<expression> 求值得到一个对象,<name> 是该对象某个属性的名称。
和前面见过的名称不同,属性名在一般环境里访问不到,而是只属于点号前面的那个对象实例。
>>> tues.year
2014对象还有方法(method),也就是取值为函数的属性。打个比方,我们说对象「知道」怎样执行这些方法。从实现上看,方法是一种函数,它的结果同时取决于传入的参数和它所属的对象。例如,tues 的 strftime 方法(一个经典的函数名,意为「string format of time」,即时间的字符串格式)接受一个参数,指定如何显示日期(比如 %A 表示星期几要全拼出来)。
>>> tues.strftime('%A, %B %d')
'Tuesday, May 13'
算出 strftime 的返回值需要两个输入:描述输出格式的字符串,以及 tues 中打包的日期信息。这个方法内部会运用日期相关的逻辑,得出结果。我们从未说过 2014 年 5 月 13 日是星期二,但知道一个日期对应星期几,本来就是「日期」这个概念的一部分。把行为和信息捆绑在一起,这个 Python 对象就为我们提供了一个令人信服、自包含的日期抽象。
日期是对象,但数字、字符串、列表和范围也都是对象。它们表示值,行为方式也贴合它们所代表的值。它们同样有属性和方法。例如,字符串有一系列便于文本处理的方法。
>>> '1234'.isnumeric()
True
>>> 'rOBERT dE nIRO'.swapcase()
'Robert De Niro'
>>> 'eyes'.upper().endswith('YES')
True
事实上,Python 中所有值都是对象。也就是说,所有值都有行为和属性,行为举止都像它们所代表的值。
2.4.2 序列对象
像数字这样的基本内置值,其实例是不可变(immutable)的。这些值本身在程序执行过程中不会改变。列表则不同,是可变(mutable)的。
可变对象用来表示随时间变化的值。一个人今天和明天还是同一个人,尽管他变老了、剪了头发,或者以别的方式有所改变。类似地,对象也可能因为修改操作而改变自身的属性。比如,列表的内容可以改变。大多数修改,都是调用列表对象的方法完成的。
我们用一个例子来介绍许多列表修改操作,它讲的是扑克牌的历史(做了大幅简化)。例子里的注释说明了每次方法调用带来的效果。
扑克牌也许是在 9 世纪前后发明于中国的。一副早期的牌有三种花色,对应货币的面额:
>>> chinese = ['coin', 'string', 'myriad']  # 一组字符串列表
>>> suits = chinese                         # 为同一个列表指定了两个不同的变量名
当纸牌传到欧洲(也许是经由埃及)后,西班牙的牌中只剩下 coin 这一种花色(oro):
>>> suits.pop()             # 从列表中移除并返回最后一个元素
'myriad'
>>> suits.remove('string')  # 从列表中移除第一个与参数相同的元素
后来(名称和样式随时间演变)又多了三种花色:
>>> suits.append('cup')              # 在列表最后插入一个元素
>>> suits.extend(['sword', 'club'])  # 将另外一个列表中的所有元素添加到当前列表最后
而意大利人把 swords 叫作 spades:
>>> suits[2] = 'spade' # 替换某个元素这样就得到了传统意大利牌的全部花色:
>>> suits
['coin', 'cup', 'spade', 'club']
如今美国用的法国变种,改掉了前两种花色:
>>> suits[0:2] = ['heart', 'diamond']  # 替换一组数据
>>> suits
['heart', 'diamond', 'spade', 'club']
此外,列表还有插入、排序和反转的方法。这些修改操作都会改变列表本身的值,而不会创建新的列表对象。
共享与身份(Sharing and Identity)。因为我们一直在改同一个列表,而不是新建列表,所以绑定到名称 chinese 的对象也变了——它和 suits 绑定的是同一个列表对象!
>>> chinese  # 这个变量名与 "suits" 指向的是同一个列表对象
['heart', 'diamond', 'spade', 'club']
这种行为是新的。以前,只要一个名称没有出现在某条语句里,它的值就不会被这条语句影响。有了可变数据,在一个名称上调用方法,会同时影响另一个名称。
这个例子的环境图表明,只涉及 suits 的语句也会改变绑定到 chinese 的值。逐行执行下面的例子,观察这些变化。
用列表构造函数 list 可以复制列表。两个列表互不影响,除非它们共享了结构。
>>> nest = list(suits)  # 复制一个与 suits 相同的列表,并命名为 nest
>>> nest[0] = suits     # 创建一个嵌套列表,列表第一项是另一个列表
按这个环境,改变 suits 引用的列表,会影响 nest 的第一个元素(也就是那个嵌套列表),但不影响其他元素。
>>> suits.insert(2, 'Joker')  # 在下标为 2 的位置插入一条新元素,其余元素相应向后移动
>>> nest
[['heart', 'diamond', 'Joker', 'spade', 'club'], 'diamond', 'spade', 'club']
同样,撤销 nest 第一个元素里的这个改动,也会改变 suits:
>>> nest[0].pop(2)
'Joker'
>>> suits
['heart', 'diamond', 'spade', 'club']
逐行执行这个例子,就能看到嵌套列表的表示形式。
两个列表可能有相同的内容,实际上是不同的列表,所以我们需要一种办法来判断两个对象是不是同一个。Python 提供了 is 和 is not 两个比较运算符,用来判断两个表达式是不是求值到同一个对象。如果两个对象当前的值相等,而且改动其中一个总会反映到另一个上,它们就是同一的(identical)。同一性(identity)是比相等性(equality)更强的条件。
>>> suits is nest[0]
True
>>> suits is ['heart', 'diamond', 'spade', 'club']
False
>>> suits == ['heart', 'diamond', 'spade', 'club']
True
最后两个比较展示了 is 和 == 的区别:前者检查同一性,后者检查内容是否相等。
列表推导式。 列表推导式总会创建一个新列表。例如,unicodedata 模块记录了 Unicode 字母表中每个字符的官方名称。我们可以按名称查找对应的字符,包括卡牌花色。
>>> from unicodedata import lookup
>>> [lookup('WHITE ' + s.upper() + ' SUIT') for s in suits]
['♡', '♢', '♤', '♧']
得到的列表不和 suits 共享任何内容,求值这个列表推导式也不会修改 suits。
你可以在 Dive into Python 3 的 Unicode 章节 读到更多关于文本表示的 Unicode 标准。
元组。 元组是内置类型 tuple 的实例,是一种不可变序列。元组用元组字面量创建:把各个元素表达式用逗号隔开即可。括号可以省略,但实际中通常都会写上。元组里可以放任意对象。
>>> 1, 2 + 3
(1, 5)
>>> ("the", 1, ("and", "only"))
('the', 1, ('and', 'only'))
>>> type( (10, 20) )
<class 'tuple'>
空元组和只有一个元素的元组,有特殊的字面量写法:
>>> ()    # 0 elements
()
>>> (10,) # 1 element
(10,)
和列表一样,元组长度固定,也支持选取元素。它还有一些和列表相同的方法,比如 count 和 index。
>>> code = ("up", "up", "down", "down") + ("left", "right") * 2
>>> len(code)
8
>>> code[3]
'down'
>>> code.count("down")
2
>>> code.index("left")
4
但元组不可变,所以那些修改列表内容的方法不能用在元组上。
虽然不能改变元组里有哪些元素,但如果其中某个元素本身可变,就可以改变它的值。
多重赋值里会隐式用到元组:把两个值赋给两个名称,会先创建一个含两个元素的元组,再解包。
2.4.3 字典
字典(dictionary)是 Python 的内置类型,用来存储和操作对应关系。一个字典包含若干键值对(key-value pair),键和值都是对象。字典的用途,是提供一种按描述性的键(而不是连续整数)存取值的抽象。
键通常用字符串,因为我们习惯用字符串表示事物的名称。下面这个字典字面量给出了几个罗马数字的值:
>>> numerals = {'I': 1.0, 'V': 5, 'X': 10}按键查找值,用的还是我们之前在序列上用过的元素选取运算符:
>>> numerals['X']
10
每个键最多只能对应一个值。增加新的键值对、修改某个键已有的值,都可以用赋值语句完成:
>>> numerals['I'] = 1
>>> numerals['L'] = 50
>>> numerals
{'I': 1, 'X': 10, 'L': 50, 'V': 5}注意上面的输出里,'L' 并没有被加到末尾。字典是键值对的无序集合。打印字典时,键和值会按某种顺序显示,但作为语言的使用者,我们无法预测这个顺序。多次运行同一个程序,顺序还可能改变。
字典也会出现在环境图里。
字典类型还支持多种遍历整个字典内容的方法。keys、values 和 items 都返回可迭代对象。
>>> sum(numerals.values())
66
调用 dict 构造函数,可以把键值对列表转换成字典。
>>> dict([(3, 9), (4, 16), (5, 25)])
{3: 9, 4: 16, 5: 25}
字典也有一些限制:
- 字典的键不能是可变值,也不能包含可变值。
- 每个键最多只能有一个值。
第一条限制和 Python 中字典的底层实现有关,实现细节不在本书讨论范围。直观地想:键告诉 Python 到内存的哪里去找这个键值对;键一旦改变,这个位置就可能丢失。字典的键常用元组,因为列表不能用作键。
第二条限制源于字典这种抽象本身:它就是用来按键存取值。只有某个键对应的值最多只有一个,我们才能取到「那个」值。
字典还实现了一个很有用的方法 get:如果键存在,就返回它对应的值;否则返回一个默认值。get 的参数是键和默认值。
>>> numerals.get('A', 0)
0
>>> numerals.get('V', 0)
5
和列表类似,字典也有推导式语法:键表达式和值表达式用冒号隔开。求值字典推导式会创建一个新的字典对象。
>>> {x: x*x for x in range(3,6)}
{3: 9, 4: 16, 5: 25}
2.4.4 局部状态
列表和字典拥有局部状态(local state):它们是会变化的值,在程序执行的任何时刻都有确定的内容。「状态」一词意味着一个演变的过程,状态在其中可能发生变化。
函数也可以有局部状态。例如,我们定义一个函数,来模拟从银行账户取钱的过程。这个函数叫 withdraw,以取款金额为参数。如果账户里的钱够取,withdraw 就返回取款后的余额;否则返回消息「余额不足」。假设账户里一开始有 100 美元,调用 withdraw 应该得到这样一串返回值:
>>> withdraw(25)
75
>>> withdraw(25)
50
>>> withdraw(60)
'余额不足'
>>> withdraw(15)
35
上面,表达式 withdraw(25) 求值了两次,却得到不同的值。因此,这个用户自定义函数不是纯函数(non-pure)。调用它不只返回值,还有副作用:它在某种程度上改变了自身,所以用同样的参数再次调用,会得到不同的结果。这个副作用,源于 withdraw 改变了当前帧之外的一个名称-值绑定。
要让 withdraw 说得通,创建它时必须给定一个初始账户余额。函数 make_withdraw 是一个高阶函数,以初始余额为参数,withdraw 就是它的返回值。
>>> withdraw = make_withdraw(100)make_withdraw 的实现需要一种新的语句:非局部语句(nonlocal statement)。调用 make_withdraw 时,我们把名称 balance 绑定到初始金额,然后定义并返回一个局部函数 withdraw;它被调用时,会更新并返回 balance 的值。
>>> def make_withdraw(balance):
        """返回一个每次调用都会减少 balance 的 withdraw 函数"""
        def withdraw(amount):
            nonlocal balance                 # 声明 balance 是非局部的
            if amount > balance:
                return '余额不足'
            balance = balance - amount       # 重新绑定
            return balance
        return withdraw
非局部语句声明:每当我们改变名称 balance 的绑定时,改动都发生在 balance 已经绑定过的第一个帧里。回想一下,没有非局部语句时,赋值语句总是会在当前环境的第一个帧里绑定名称。非局部语句表明,这个名称出现在环境中的某个地方,既不是第一个(局部)帧,也不是最后一个(全局)帧。
下面的环境图展示了多次调用 make_withdraw 所创建函数的效果。
第一个 def 语句的效果和往常一样:它创建一个新的用户自定义函数,并在全局帧中把名称 make_withdraw 绑定到这个函数上。随后调用 make_withdraw,创建并返回一个局部定义的函数 withdraw。名称 balance 绑定在这个函数的父帧里。关键在于,在这个例子的后续部分里,balance 只有这一个绑定。
接下来,我们求值一个表达式:调用绑定到名称 wd 的这个函数,参数是 5。withdraw 的函数体在一个新环境里执行,这个环境扩展自定义 withdraw 的环境。跟踪 withdraw 的求值过程,就能看到 Python 中非局部语句的效果:第一个局部帧之外的名称,可以被赋值语句改变。
非局部语句会改变 withdraw 定义中剩余的所有赋值语句。执行 nonlocal balance 之后,任何把 balance 放在 = 左边的赋值语句,都不会在当前环境的第一个帧里绑定 balance,而是找到 balance 已经定义过的第一个帧,在那个帧里重新绑定。如果 balance 之前没有被绑定过值,非局部语句就会报错。
改变 balance 的绑定,也就改变了 withdraw 函数。下一次调用它时,名称 balance 求值为 15 而不是 20。因此,第二次调用 withdraw 时,返回值是 12 而不是 17。第一次调用对 balance 的改变,影响了第二次调用的结果。
第二次调用 withdraw,照例创建了第二个局部帧。不过,两个 withdraw 帧的父帧相同:它们都扩展自 make_withdraw 的环境,而 balance 的绑定就在这个环境里。所以它们共享这个名称绑定。调用 withdraw 会改变未来调用 withdraw 时所扩展的环境。非局部语句让 withdraw 能改变 make_withdraw 帧里的名称绑定。
从我们第一次遇到嵌套 def 语句起就注意到:局部定义的函数可以查找局部帧之外的名称。访问非局部名称并不需要非局部语句;但只有写了非局部语句之后,函数才能改变这些帧里名称的绑定。
引入非局部语句,让赋值语句有了双重作用:要么改变局部绑定,要么改变非局部绑定。其实赋值语句早就有双重作用:要么创建新的绑定,要么重新绑定已有的名称。赋值还可以改变列表和字典的内容。Python 赋值的多重作用,可能让赋值语句执行后的效果变得难以看清。作为程序员,你有责任把代码写清楚、注释明白,让别人能看懂赋值带来的效果。
Python 的特质(Python Particulars)。 这种非局部赋值的模式,是带高阶函数和词法作用域的语言共有的特征。大多数其他语言根本不需要非局部语句,非局部赋值往往就是赋值语句的默认行为。
Python 在名称查找上还有一条不常见的限制:在一个函数体内,同一个名称的所有出现都必须指向同一个帧。因此,Python 无法在非局部帧里查找一个名称的值,再在局部帧里绑定同一个名称,因为同一个名称会在同一个函数的两个不同帧里被访问。有了这条限制,Python 就能在执行函数体之前预先算出每个名称属于哪个帧。违反这条限制时,会得到让人摸不着头脑的错误消息。为了演示,下面把 make_withdraw 的例子重复一遍,但去掉了非局部语句。
出现 UnboundLocalError,是因为 balance 在第 5 行被局部赋值,所以 Python 认为对 balance 的所有引用也都必须出现在局部帧里。这个错误在第 5 行执行之前就发生了,说明 Python 在执行第 3 行之前,就以某种方式考虑过第 5 行。等我们研究解释器设计时就会看到,在执行函数体之前预先算出关于它的一些事实,是很常见的做法。这里,Python 的预处理限定了 balance 能出现的帧,于是这个名称就找不到了。加上非局部语句就能修好这个错误。Python 2 中没有非局部语句。
2.4.5 非局部赋值的好处
非局部赋值,是让我们把程序看作一群独立自治对象的路上重要的一步:这些对象彼此交互,但各自管理自己的内部状态。
具体来说,非局部赋值让我们能维护某个函数的局部状态,而这份状态会随着对该函数的连续调用而变化。某个 withdraw 函数关联的 balance,会在该函数的所有调用之间共享。但程序的其余部分访问不到某个 withdraw 实例关联的 balance 绑定。只有 wd 与定义它的那个 make_withdraw 帧相关联。如果再次调用 make_withdraw,它会创建一个单独的帧,其中有一个单独的 balance 绑定。
我们可以扩展这个例子来说明这一点:第二次调用 make_withdraw,会返回第二个 withdraw 函数,它的父帧不同。我们把这个函数绑定到全局帧中的名称 wd2。
现在可以看到,名称 balance 实际上在两个不同的帧里各有一个绑定,两个 withdraw 函数的父帧也不同。名称 wd 绑定到一个 balance 为 20 的函数,而 wd2 绑定到另一个 balance 为 7 的函数。
调用 wd2 会改变它非局部名称 balance 的绑定,但不会影响绑定到名称 withdraw 的那个函数。以后调用 wd 不受 wd2 的 balance 变化影响;wd 的 balance 仍然是 20。
这样,每个 withdraw 实例都维护自己的 balance 状态,但程序中的其他函数都访问不到这份状态。从更高的层面看,我们抽象出了一个银行账户:它自己管理内部状态,行为模拟了现实世界中的账户——会随时间的推移,根据自己过去的取款记录而变化。
2.4.6 非局部赋值的代价
我们的环境计算模型能干净利落地扩展,解释非局部赋值的效果。不过,非局部赋值也在我们看待名称和值的方式上引入了一些重要的细微差别。
以前,值从不改变,改变的只有名称和绑定。当两个名称 a 和 b 都绑定到值 4 时,它们绑定的是同一个 4 还是不同的 4 并不重要。就我们所能观察到的而言,只有一个从未改变的 4 对象。
但有状态的函数不是这样。当两个名称 wd 和 wd2 都绑定到一个 withdraw 函数时,它们绑定的是同一个函数,还是该函数的不同实例,就很要紧了。看下面这个例子,它和刚才分析的那个正好相反:这里,调用名称 wd2 所指的函数,确实改变了名称 wd 所指的函数的值,因为两个名称引用的是同一个函数。
两个名称指向同一个值,这在现实中很常见,在程序里也一样。但值会随时间变化,所以我们必须格外小心,弄清一次改变会如何影响其他可能引用这些值的名称。
要正确分析带非局部赋值的代码,关键是记住:只有函数调用才会引入新帧。赋值语句只改变已有帧里的绑定。这里,除非 make_withdraw 被调用两次,否则 balance 只会有一个绑定。
相同与变化(Sameness and change)。 这些细微差别之所以出现,是因为我们引入了会改变非局部环境的非纯函数,从而改变了表达式的性质。仅包含纯函数调用的表达式是引用透明(referentially transparent)的:把其中一个子表达式替换成它的值,表达式的值不会改变。
重新绑定操作违反了引用透明的条件,因为它们不只是返回值,还会改变环境。一旦引入任意的重新绑定,我们就碰上一个棘手的认识论问题:两个值相同到底意味着什么。在我们的环境计算模型中,分别定义的两个函数是不同的,因为改动其中一个,未必会反映到另一个上。
一般来说,只要我们从不修改数据对象,就可以把复合数据对象看作它各个部分的全体。例如,有理数由它的分子和分母确定。但一旦有了变化,这种观点就不再成立:复合数据对象的「身份」,与组成它的那些部分并不相同。即使我们取款改变了 balance,银行账户仍然是「同一个」账户;反过来,我们也可以有两个账户,它们碰巧 balance 相同,却是不同的对象。
尽管非局部赋值带来了这些复杂性,它仍是打造模块化程序的有力工具。程序中对应不同环境帧的不同部分,可以在执行过程中各自演变。此外,借助有局部状态的函数,我们能实现可变数据类型。事实上,我们还能实现抽象数据类型,它们和前面介绍的内置 list 和 dict 类型等价。
2.4.7 实现列表和字典
Python 不让我们接触列表的实现,只提供语言内置的序列抽象和修改方法。为了理解怎样用有局部状态的函数表示可变列表,我们现在来实现一个可变链表。
我们用一个函数来表示可变链表,把链表作为它的局部状态。和所有可变值一样,列表需要有身份。具体来说,我们不能用 None 来表示空的可变列表,因为两个空列表并不是同一个值(比如,往其中一个追加元素,另一个不会跟着变),而 None 始终是 None。另一方面,两个不同的函数,只要各自的局部状态都是 empty,就足以区分两个空列表。
如果可变链表是一个函数,它需要什么参数?答案体现了编程中的一个普遍模式:它是一个分派(dispatch)函数,参数首先是消息(message),然后是给这个方法补充的参数。消息是一个字符串,说明函数该做什么。分派函数实际上是把多个函数合成了一个:消息决定函数的行为,其余参数在该行为里使用。
我们的可变列表会响应五条不同的消息:len、getitem、push_first、pop_first 和 str。前两条实现序列抽象的行为,接下来两条添加或删除列表的第一个元素,最后一条消息返回整个链表的字符串表示。
>>> def mutable_link():
        """返回一个可变链表的函数"""
        contents = empty
        def dispatch(message, value=None):
            nonlocal contents
            if message == 'len':
                return len_link(contents)
            elif message == 'getitem':
                return getitem_link(contents, value)
            elif message == 'push_first':
                contents = link(value, contents)
            elif message == 'pop_first':
                f = first(contents)
                contents = rest(contents)
                return f
            elif message == 'str':
                return join_link(contents, ", ")
        return dispatch
我们还可以加一个便利函数,从任意内置序列构造一个函数式实现的链表,只需把每个元素按相反顺序添加进去。
>>> def to_mutable_link(source):
        """返回一个与原列表相同内容的函数列表"""
        s = mutable_link()
        for element in reversed(source):
            s('push_first', element)
        return s
上面的定义里,函数 reversed 接受并返回一个可迭代对象;它是又一个处理序列的函数的例子。
到这里,我们就能构造一个函数式实现的可变链表了。注意,链表本身就是一个函数。
>>> s = to_mutable_link(suits)
>>> type(s)
<class 'function'>
>>> print(s('str'))
heart, diamond, spade, club
此外,我们可以向这个列表 s 传递消息来改变它的内容,比如删除第一个元素。
>>> s('pop_first')
'heart'
>>> print(s('str'))
diamond, spade, club原则上,push_first 和 pop_first 两个操作就足以对列表做任意修改。我们总能先把列表清空,再用想要的结果替换掉原来的内容。
消息传递(Message passing)。 假以时日,我们还能实现 Python 列表的许多有用修改操作,比如 extend 和 insert。我们有两种选择:可以把它们全都实现为函数,复用已有的 pop_first 和 push_first 消息来完成修改;或者在 dispatch 函数体里增加 elif 子句,每条子句检查一种消息(比如 'extend'),直接对内容做相应的修改。
第二种方法把对一个数据值的所有操作的逻辑,封装在一个响应不同消息的函数里,这套做法就叫消息传递。使用消息传递的程序会定义分派函数,每个函数都可以有局部状态,并把「消息」作为第一个参数传给这些函数,以此组织计算。消息就是对应特定行为的字符串。
实现字典(Implementing Dictionaries)。 我们还可以实现一个行为与字典类似的值。这里,我们用键值对列表来保存字典的内容,每个键值对都是一个含两个元素的列表。
>>> def dictionary():
        """返回一个字典的函数实现"""
        records = []
        def getitem(key):
            matches = [r for r in records if r[0] == key]
            if len(matches) == 1:
                key, value = matches[0]
                return value
        def setitem(key, value):
            nonlocal records
            non_matches = [r for r in records if r[0] != key]
            records = non_matches + [[key, value]]
        def dispatch(message, key=None, value=None):
            if message == 'getitem':
                return getitem(key)
            elif message == 'setitem':
                setitem(key, value)
return dispatch同样,我们用消息传递来组织这个实现。它支持两条消息:getitem 和 setitem。要为某个键插入值,先滤掉所有具有该键的已有记录,再加上一条新的,这样就能保证每个键在记录里只出现一次。要查找某个键的值,就筛出与该键匹配的记录。现在就可以用这个实现来存取值了。
>>> d = dictionary()
>>> d('setitem', 3, 9)
>>> d('setitem', 4, 16)
>>> d('getitem', 3)
9
>>> d('getitem', 4)
16
这种字典实现并没有为快速查找记录做优化,每次查找都得筛一遍全部记录。内置的字典类型效率高得多,它的实现方式不在本书讨论范围之内。
2.4.8 分派字典
dispatch 函数是实现抽象数据消息传递接口的通用方法。到目前为止,为了实现消息分派,我们一直用条件语句,把消息字符串和一组固定的已知消息作比较。
内置的字典数据类型提供了按键查找值的通用方法。所以,我们可以用键为字符串的字典来实现分派,而不必用条件语句。
下面的可变账户数据类型是用字典实现的。它有一个构造函数 account 和选择函数 check_balance,以及存款、取款函数。此外,账户的局部状态和实现其行为的函数一起存在这个字典里。
在 account 构造函数的函数体里,名称 dispatch 绑定到一个字典,字典的键是账户能接受的消息。balance 是一个数字,而消息 deposit 和 withdraw 绑定到函数。这些函数可以访问 dispatch 字典,所以能读取和改变 balance。把 balance 存进 dispatch 字典,而不是直接存在账户帧里,就不用给 deposit 和 withdraw 加非局部语句了。
运算符 += 和 -= 是 Python(以及许多其他语言)里「查找再重新赋值」的简写。下面最后两行是等价的。
>>> a = 2
>>> a = a + 1
>>> a += 1
2.4.9 约束传递
可变数据让我们能模拟会变化的系统,也能构建新一类的抽象。在这个扩展例子中,我们把非局部赋值、列表和字典结合起来,构建一个基于约束的系统,支持多方向的计算。把程序表示为约束,属于声明式编程(declarative programming):程序员只声明待解决问题的结构,而把具体怎么求解的细节抽象掉。
计算机程序传统上是按单向计算来组织的:对预先给定的参数施加操作,得到想要的输出。但我们常常希望按量之间的关系来给系统建模。例如,前面讨论过理想气体状态方程,它借助玻尔兹曼常数(k),把理想气体的压力(p)、体积(v)、数量(n)和温度(t)联系起来:
p * v = n * k * t
这样的方程不是单向的:只要给出其中四个量,就能用这个方程算出第五个。但把方程翻译成传统计算机语言,就不得不选定一个量,让它由其余四个量算出。这样一来,算压力的函数就不能拿来算温度,尽管这两个量的计算出自同一个方程。
本节勾勒一个线性关系通用模型的设计。我们定义量之间成立的基本约束,比如强制满足数学关系 a + b = c 的 adder(a, b, c) 约束。
我们还定义一种组合方式,让基本约束能组合起来表达更复杂的关系。这样,我们的程序就类似于一种编程语言。我们把约束组合成一个网络,其中约束由连接器(connector)连接。连接器是一个对象,它「持有」一个值,并且可以参与一个或多个约束。
例如,我们知道华氏温度和摄氏温度之间的关系是:
9 * c = 5 * (f - 32)
这个等式是 c 和 f 之间的一个复杂约束。这样的约束可以看成由基本的加法器(adder)、乘法器(multiplier)和常量(constant)约束组成的网络。
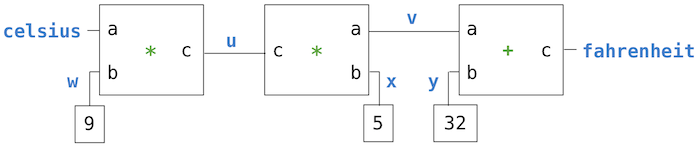
图中左侧是一个乘法器,有三个端口,标记为 a、b 和 c。它们把乘法器接到网络的其余部分,具体如下:a 端口连接到连接器 celsius,这个连接器将保存摄氏温度。b 端口连接到连接器 w,w 又链接到保存 9 的常量。c 端被乘法器约束为 a 与 b 的乘积,它链接到另一个乘法器的 c 端,而那个乘法器的 b 连接到常量 5,a 又接到加法器的一项上。
这样的网络,计算过程如下:一个连接器被赋予值时(由用户,或由它链接到的约束框赋予),它会唤醒所有相关的约束(刚刚唤醒它的那个除外),告诉它们自己有值。每个被唤醒的约束框随后会询问自己的连接器,看看信息是否足够确定某个连接器的值。如果够,这个框就设置该连接器,后者再唤醒所有相关的约束,如此下去。例如,在摄氏度和华氏度的转换中,w、x 和 y 立刻被常量框分别设为 9、5 和 32。连接器唤醒乘法器和加法器,它们发现信息还不足以继续。如果用户(或网络的其他部分)把 celsius 连接器设成一个值(比如 25),最左边的乘法器会被唤醒,把 u 设为 25 * 9 = 225。然后 u 唤醒第二个乘法器,把 v 设为 45,v 再唤醒加法器,把 fahrenheit 连接器设为 77。
使用约束系统(Using the Constraint System)。 要用约束系统完成上面说的温度计算,先调用连接器构造函数 connector,创建两个有名字的连接器:celsius 和 fahrenheit。
>>> celsius = connector('Celsius')
>>> fahrenheit = connector('Fahrenheit')
然后,把这些连接器链接成一个网络,对应上面的图。函数 converter 负责组装网络中的各个连接器和约束。
>>> def converter(c, f):
        """用约束条件连接 c 到 f,将摄氏度转换为华氏度."""
        u, v, w, x, y = [connector() for _ in range(5)]
        multiplier(c, w, u)
        multiplier(v, x, u)
        adder(v, y, f)
        constant(w, 9)
        constant(x, 5)
constant(y, 32)>>> converter(celsius, fahrenheit)我们用消息传递来协调约束和连接器。约束本身是不持有局部状态的字典;它们对消息的响应是非纯函数,会改变它们约束的连接器。
连接器是保存当前值、并响应操纵该值的消息的字典。约束不直接改连接器的值,而是发消息,好让连接器在变化后通知其他约束。这样,连接器既代表一个数字,又封装了连接器自身的行为。
我们可以给连接器发一条消息来设置它的值。这里,我们('user')把 celsius 的值设为 25。
>>> celsius['set_val']('user', 25)
Celsius = 25
Fahrenheit = 77.0
不仅 celsius 的值变成 25,这个值还会在网络中传播,于是 fahrenheit 的值也随之改变。之所以会打印这些变化,是因为我们在构造时给这两个连接器起了名字。
现在试着把 fahrenheit 设成一个新值,比如 212。
>>> fahrenheit['set_val']('user', 212)
Contradiction detected: 77.0 vs 212
连接器抱怨说它检测到了矛盾:它的值是 77.0,而有人想把它设成 212。如果我们真的想用新值复用这个网络,可以告诉 celsius 忘掉它的旧值:
>>> celsius['forget']('user')
Celsius is forgotten
Fahrenheit is forgotten
连接器 celsius 发现,最初设置它值的那个用户现在要收回该值,于是 celsius 同意失去自己的值,并把这件事通知网络的其他部分。这个信息最终传到 fahrenheit,它发现自己没有理由再相信自己的值是 77,于是也放弃了它的值。
现在 fahrenheit 没有值了,我们可以把它设成 212:
>>> fahrenheit['set_val']('user', 212)
Fahrenheit = 212
Celsius = 100.0
这个新值在网络中传播时,迫使 celsius 的值变为 100。我们用完全相同的网络,既能由 fahrenheit 算 celsius,也能由 celsius 算 fahrenheit。计算的这种无方向性,正是基于约束的系统最突出的特点。
实现约束系统(Implementing the Constraint System)。 如前所述,连接器是把消息名称映射到函数和数据值的字典。我们要实现的连接器会响应以下消息:
>>> connector ['set_val'](source, value)  """表示 source 在请求连接器将当前值设为 value"""
>>> connector ['has_val']()  """返回连接器是否已经具有值"""
>>> connector ['val']  """是连接器的当前值"""
>>> connector ['forget'](source)  """告诉连接器 source 请求遗忘它的值"""
>>> connector ['connect'](source)  """告诉连接器参与新的约束,即 source"""
约束也是字典,它通过两条消息从连接器接收信息:
>>> constraint['new_val']()  """表示与约束相连的某个连接器具有新的值。"""
>>> constraint['forget']()  """表示与约束相连的某个连接器遗忘了值。"""
约束收到这些消息后,会把它们相应地传播给其他连接器。
adder 函数在三个连接器上构造一个加法器约束,要求前两个相加等于第三个:a + b = c。为了支持多向的约束传播,加法器还必须说明:从 c 减去 a 得到 b,同理从 c 减去 b 得到 a。
>>> from operator import add, sub
>>> def adder(a, b, c):
        """约束 a+b=c"""
        return make_ternary_constraint(a, b, c, add, sub, sub)
我们想实现一个通用的三元(三向)约束:用 adder 传来的三个连接器和三个函数,创建一个接受 new_val 和 forget 消息的约束。对消息的响应是一些局部函数,它们放在名为 constraint 的字典里。
>>> def make_ternary_constraint(a, b, c, ab, ca, cb):
        """约束 ab(a,b)=c,ca(c,a)=b,cb(c,b)=a"""
        def new_value():
            av, bv, cv = [connector['has_val']() for connector in (a, b, c)]
            if av and bv:
                c['set_val'](constraint, ab(a['val'], b['val']))
            elif av and cv:
                b['set_val'](constraint, ca(c['val'], a['val']))
            elif bv and cv:
                a['set_val'](constraint, cb(c['val'], b['val']))
        def forget_value():
            for connector in (a, b, c):
                connector['forget'](constraint)
        constraint = {'new_val': new_value, 'forget': forget_value}
        for connector in (a, b, c):
            connector['connect'](constraint)
        return constraint
名为 constraint 的字典是一个分派字典,同时也是约束对象本身。它既响应约束会收到的两条消息,又作为 source 参数传给它的连接器。
每当约束得知自己的某个连接器有了值,就会调用它的局部函数 new_value。这个函数先检查 a 和 b 是否都有值。如果是,就告诉 c 把值设为函数 ab 的返回值(对加法器来说就是 add)。约束把自身(constraint)作为连接器的 source 参数传入,这个连接器就是加法器对象。如果 a 和 b 不都有值,约束就转而检查 a 和 c,依此类推。
如果约束得知某个连接器忘记了自己的值,它就请自己的所有连接器忘掉各自的值。(实际上,只有那些由这个约束设置的值才会真正丢失。)
乘法器与加法器非常相似。
>>> from operator import mul, truediv
>>> def multiplier(a, b, c):
        """约束 a*b=c"""
        return make_ternary_constraint(a, b, c, mul, truediv, truediv)
常量也是一种约束,但它永远不会收到任何消息,因为它只涉及一个连接器,并且在构造时就把它设置好。
>>> def constant(connector, value):
        """常量赋值"""
        constraint = {}
        connector['set_val'](constraint, value)
        return constraint
这三种约束就足以实现我们的温度转换网络。
连接器的表示(Representing connectors)。 连接器表示为一个字典,其中有一个值,还有带局部状态的响应函数。连接器必须跟踪 informant(提供当前值的来源),以及它参与其中的约束列表。
构造函数 connector 带有设置值和遗忘值的局部函数,它们是对来自约束的消息的响应。
>>> def connector(name=None):
        """限制条件之间的连接器"""
        informant = None
        constraints = []
        def set_value(source, value):
            nonlocal informant
            val = connector['val']
            if val is None:
                informant, connector['val'] = source, value
                if name is not None:
                    print(name, '=', value)
                inform_all_except(source, 'new_val', constraints)
            else:
                if val != value:
                    print('Contradiction detected:', val, 'vs', value)
        def forget_value(source):
            nonlocal informant
            if informant == source:
                informant, connector['val'] = None, None
                if name is not None:
                    print(name, 'is forgotten')
                inform_all_except(source, 'forget', constraints)
        connector = {'val': None,
                     'set_val': set_value,
                     'forget': forget_value,
                     'has_val': lambda: connector['val'] is not None,
                     'connect': lambda source: constraints.append(source)}
        return connector
连接器同样是分派字典,处理约束用来与连接器通信的五条消息。其中四个响应是函数,最后一个响应就是值本身。
当有人请求设置连接器的值时,就调用局部函数 set_value。如果连接器当前没有值,它会设置值,并把请求设置值的源约束记为 informant。然后,连接器通知所有参与的约束,但请求设置值的那个除外。这靠下面这个迭代函数完成。
>>> def inform_all_except(source, message, constraints):
        """告知信息除了 source 外的所有约束条件"""
        for c in constraints:
            if c != source:
                c[message]()
如果要求连接器忘记它的值,它会调用局部函数 forget-value,该函数先确认这个请求来自最初设置该值的同一个约束。如果是,连接器就通知它的各个约束:这个值丢失了。
对消息 has_val 的响应,表明连接器是否有值;对消息 connect 的响应,把源约束加入约束列表。
我们设计的约束程序引入了许多会在面向对象编程中再次出现的思想。约束和连接器都是靠消息操作的抽象。连接器的值发生变化时,是经由一条消息改变的;这条消息不仅改值,还会校验(检查来源)并把影响传播出去(通知其他约束)。事实上,本章后面我们会用类似的架构——键为字符串、值为函数的字典——来实现面向对象的系统。