
1.6 高阶函数
INFO
我们已经看到,函数是一种抽象方法,它描述的是与具体参数值无关的复合操作。比如在 square 里:
>>> def square(x):
return x * x我们谈论的并不是某个特定数字的平方,而是求任意数字平方的一种方法。
当然,我们也可以完全不定这个函数,每次都直接写:
>>> 3 * 3
9
>>> 5 * 5
25
从不显式提到 square。对求平方这样简单的计算,这种做法倒也够用;但遇到 abs、fib 这类更复杂的例子,再这么写就会非常繁琐。
一般来说,如果语言缺少函数定义能力,我们就只能一直停留在语言恰好提供的那些基本操作(这里是乘法)的层面上,而无法用更高层次的操作来思考。程序仍然能算出平方,但语言本身失去了表达「求平方」这个概念的能力。
一个强大的编程语言应该具备的能力之一,就是给常见模式命名来建立抽象,然后直接使用这些名字来编程。函数正是提供了这种能力。
接下来的例子会说明,代码中常常出现一些反复使用的编程模式,只是每次配合使用的具体函数不同。这些模式同样可以抽象出来,办法就是给它们命名。
要把某些通用模式表达成具名的概念(named concepts),我们需要构造一种可以接收其他函数作为参数或可以把函数当作返回值的函数。这种能操作函数的函数,就叫高阶函数(higher-order functions)。
本节将展示,高阶函数如何作为一种强大的抽象机制,极大地增强语言的表达能力。
1.6.1 函数作为参数
思考下面三个计算求和的函数。
第一个函数 sum_naturals 计算从 1 到 n 的自然数之和:
>>> def sum_naturals(n):
     total, k = 0, 1
     while k <= n:
         total, k = total + k, k + 1
     return total

>>> sum_naturals(100)
5050
第二个函数 sum_cubes 计算 1 到 n 的自然数的立方之和。
>>> def sum_cubes(n):
     total, k = 0, 1
     while k <= n:
         total, k = total + k*k*k, k + 1
     return total

>>> sum_cubes(100)
25502500
第三个函数 pi_sum 计算下面这个级数各项之和,这个级数收敛到
>>> def pi_sum(n):
     total, k = 0, 1
     while k <= n:
         total, k = total + 8 / ((4*k-3) * (4*k-1)), k + 1
     return total

>>> pi_sum(100)
3.1365926848388144这三个函数显然共享同一个底层模式。它们几乎一模一样,唯一的区别在于函数名,以及用 k 计算待加项的那个函数。
其实,只要往同一个模板的槽位里填上不同内容,就能生成这三个函数:
def <name>(n):
    total, k = 0, 1
    while k <= n:
        total, k = total + <term>(k), k + 1
return total有这样一个共同模式,强烈暗示着背后藏着一个有用的抽象,等着被挖掘出来。这三个函数本质上都是「把若干项加起来」。作为程序设计者,我们希望语言足够强大,能直接写出一个表达「求和」这个概念本身的函数,而不只是写出计算某些特定和的函数。
在 Python 里做到这一点很容易:把上面模板中的「槽位」变成形式参数即可。
下面的例子里,summation 接收两个参数:上界 n,以及计算第 k 项的函数 term。我们可以像用任何函数那样使用 summation,它简洁地表达了求和的概念。
花点时间单步执行(step through)这个例子,注意把 cube 绑定到局部名称 term,就保证了结果
借助一个直接返回自己参数的恒等函数 identity,我们也能用完全相同的 summation 对自然数求和。
>>> def summation(n, term):
        total, k = 0, 1
        while k <= n:
            total, k = total + term(k), k + 1
        return total
>>> def identity(x):
        return x
>>> def sum_naturals(n):
        return summation(n, identity)
>>> sum_naturals(10)
55
也可以直接调用 summation,不必为某个特定序列再定义一个函数。
>>> summation(10, square)
385
我们可以定义一个 pi_term 函数来计算每一项,再用 summation 这个抽象来定义 pi_sum。传入参数 1e6(1 * 10 6 = 1000000 的简写),就能得到
>>> def pi_term(x):
        return 8 / ((4*x-3) * (4*x-1))
>>> def pi_sum(n):
        return summation(n, pi_term)
>>> pi_sum(1e6)
3.141592153589902
1.6.2 函数作为通用方法
我们最初引入用户自定义函数,是为了把数值运算的模式抽象出来,让它们不再依赖具体的数字。
引入高阶函数之后,我们开始看到一种更强大的抽象:有些函数表达的是通用的计算方法,与它们具体调用哪些函数无关。
函数的含义虽然在概念上有了这样的扩展,但我们用来求值调用表达式的环境模型,依然能顺理成章地扩展到高阶函数的情形,无需任何改动。
把一个用户自定义函数施加到一些参数上时,形式参数会在新的局部帧里绑定到这些参数的值(这些值也可能是函数)。
思考下面的例子,它实现了一种通用的迭代改进(iterative improvement)算法,并用它计算黄金分割率。黄金分割率 通常被称为「phi」,是一个接近 1.6 的数,频繁出现在自然、艺术和建筑中。
迭代改进算法的做法是:从一个方程解的 guess(推测值)开始,反复施加 update 函数来改进这个猜测值,再用 close 做一次接近比较,检查当前的 guess 是否已经足够接近,可以视为正确。
>>> def improve(update, close, guess=1):
     while not close(guess):
         guess = update(guess)
     return guess
这个 improve 函数是重复优化(repetitive refinement)这一过程的通用表达。它不指定要解决什么具体问题:所有细节都留给了作为参数传入的 update 和 close。
黄金分割率有几个著名性质:反复把任意正数的倒数加 1,就能算出它;同时它比自己的平方小 1。我们可以把这些性质写成函数,供 improve 使用:
>>> def golden_update(guess):
     return 1/guess + 1

>>> def square_close_to_successor(guess):
     return approx_eq(guess * guess, guess + 1)
这里我们引入了一个对 approx_eq 的调用:如果它的参数近似相等,就返回 True。实现 approx_eq 时,可以把两个数之差的绝对值和一个很小的容差(tolerance value)比较:
>>> def approx_eq(x, y, tolerance=1e-15):
     return abs(x - y) < tolerance
把 golden_update 和 square_close_to_successor 作为参数调用 improve,就能算出黄金分割率的一个有限近似值。
>>> improve(golden_update, square_close_to_successor)
1.6180339887498951
一步步跟踪求值过程,就能看清这个结果是怎么算出来的。首先,为 improve 创建一个局部帧,把 update、close 和 guess 绑定进去。然后在 improve 的函数体里,名称 close 绑定到 square_close_to_successor,程序会用 guess 的初始值调用它。继续跟踪剩下的步骤,就能看到这个过程如何一步步演变,最终算出黄金分割率。
这个例子说明了计算机科学中两个相关的重要思想:
- 有了命名和函数,我们就能把大量复杂性抽象掉。每个单独的函数定义都很简单,但由求值流程启动起来的整个计算过程却相当精巧。
- 正是因为 Python 拥有极其通用的求值流程,小的组件才能组合成复杂的计算。理解程序的解释过程,让我们能够验证和检查自己创造出来的计算过程。
一如既往,我们的新通用方法 improve 需要测试来检验正确性。黄金分割率正好可以充当这个测试,因为它有一个精确的闭式解,可以拿来和迭代结果对比:
>>> from math import sqrt
>>> phi = 1/2 + sqrt(5)/2
>>> def improve_test():
        approx_phi = improve(golden_update, square_close_to_successor)
        assert approx_eq(phi, approx_phi), 'phi differs from its approximation'
>>> improve_test()对这个测试来说,没有消息就是好消息:improve_test 的 assert 语句执行成功后,函数会返回 None。
1.6.3 定义函数 III:嵌套定义
上面的例子已经说明,能传递函数作为参数,会极大地增强编程语言的表达力。每一个通用概念或方程,都能对应上一个短小的函数。
但这种方式有两个负面后果:
- 全局帧会被各种小函数的名字塞满,而且这些名字都必须全局唯一;
- 我们还受特定函数签名的限制:
improve的update参数必须恰好接受一个参数。
嵌套函数定义(Nested function definition)能同时解决这两个问题,但需要我们对环境模型做进一步扩充。
现在考虑一个新问题:求一个数的平方根(在编程语言中常简写为 sqrt)。反复施加下面的更新规则,就能收敛到 a 的平方根:
>>> def average(x, y):
     return (x + y)/2

>>> def sqrt_update(x, a):
     return average(x, a/x)
但这个需要两个参数的 sqrt_update 与 improve 不兼容(它要两个参数,不是一个);而且它只提供了一次更新,而我们真正想要的是反复更新来求平方根。这两个问题的解决办法,都是把函数定义放进另一个函数体内部:
>>> def sqrt(a):
     def sqrt_update(x):
         return average(x, a/x)
     def sqrt_close(x):
         return approx_eq(x * x, a)
     return improve(sqrt_update, sqrt_close)
和局部赋值一样,局部的 def 语句只影响当前局部帧。这些函数只在 sqrt 被求值期间处于作用域内。按照我们的求值流程,这些局部 def 语句甚至要等到 sqrt 被调用时才会求值。
词法作用域(Lexical scope)。局部定义的函数还能访问定义它们时所在作用域里的名字绑定。
在这个例子里,sqrt_update 引用了名字 a,而 a 是外层函数 sqrt 的形式参数。
这种在嵌套定义之间共享名字的规则,叫做词法作用域。关键在于:内部函数能访问的是它们被定义时所在环境里的名字,而不是被调用时所在环境里的名字。
要让词法作用域生效,环境模型需要两点扩充:
- 每个用户自定义函数都有一个父环境:即定义它的那个环境。
- 调用用户自定义函数时,它的局部帧扩展它的父环境。
在 sqrt 之前,所有函数都定义在全局环境里,因此它们的父环境都相同:全局环境。
而在 Python 求值 sqrt 的前两个子句时,创建出来的函数关联的是一个局部环境。在这次调用中:
>>> sqrt(256)
16.0
环境先为 sqrt 添加一个局部帧,再求值 sqrt_update 和 sqrt_close 的 def 语句。
从现在起,环境图里会给每个函数值加一个新的标注——parent(父环境)。函数值的父环境,就是定义该函数时所在环境的第一个帧。没有标注 parent 的函数,是在全局环境里定义的。调用用户自定义函数时,创建的帧和该函数拥有相同的父环境。
随后,名称 sqrt_update 解析为刚刚定义的函数,并作为参数传给 improve。在 improve 的函数体里,我们要把 update 函数(此时绑定为 sqrt_update)施加到初始猜测值 x 上,也就是 1。这最后一次施加为 sqrt_update 创建了一个环境,它以一个只含 x 的局部帧开头,而父帧 sqrt 里仍然保留着 a 的绑定。
求值流程最关键的一点,就是把 sqrt_update 的 parent 传给调用它时创建的帧。这个帧同样标注为 [parent=f1]。
扩展环境(Extended Environments)。一个环境可以由任意长的帧链构成,并且总以全局帧结尾。
在 sqrt 这个例子之前,环境最多只包含两个帧:一个局部帧和一个全局帧。而调用由嵌套 def 语句定义在别的函数里的函数,就能创建更长的帧链。这次调用 sqrt_update 的环境由三个帧组成:
sqrt_update局部帧- 它的父帧 f1(
sqrt的帧,包含a = 256) - 全局帧
在 sqrt_update 函数体的返回表达式里,可以通过这条帧链求出 a 的值。查找一个名称时,Python 会找到当前环境里最早绑定该名称的那个值:先查 sqrt_update 帧——里面没有 a;再查父帧 f1,发现 a 绑定到 256。
于是,我们看到了 Python 词法作用域的两个关键优势:
- 局部函数的名字不会和定义它的那个函数之外的名字冲突,因为局部函数的名字绑定在定义它的当前局部环境里,而不是全局环境。
- 局部函数可以访问外层函数的环境,因为局部函数的函数体是在一个扩展了定义环境的环境里求值的。
sqrt_update 函数还随身带着一些数据:定义它的环境里引用的 a 的值。正因为它以这种方式「封装」了信息,局部定义的函数通常被称为闭包(closures)。
1.6.4 函数作为返回值
让函数的返回值本身也是函数,程序就能获得更强的表达能力。词法作用域语言有一个重要特性:局部定义的函数被返回时,依然保留自己的父环境。下面的例子说明了这一特性的用处。
定义好许多简单函数之后,函数复合(composition)自然就成了语言中一种值得纳入的组合方式。
也就是说,给定两个函数 f(x) 和 g(x),我们可能想定义 h(x) = f(g(x))。用现有的工具就能定义函数复合:
>>> def compose1(f, g):
        def h(x):
            return f(g(x))
        return h
这个例子的环境图展示了即使存在名称冲突,名称 f 和 g 也能被正确解析。
compose1 里的 1 表示被复合的函数都只接受单个参数。这个命名惯例不是解释器强制要求的;1 只是函数名的一部分。
到这里,我们开始尝到为计算的环境模型下精确定义的好处:要解释这种返回函数的能力,环境模型不用做任何修改。
1.6.5 示例:牛顿法
这个扩展示例展示了函数返回值和局部定义如何协同工作,简洁地表达通用思想。我们将实现一种广泛用于机器学习、科学计算、硬件设计和优化的算法。
牛顿法(Newton's method)是一种经典的迭代方法,用来寻找使某个数学函数返回 0 的参数值,这些值称为函数的零点(zeros)。求函数的零点,往往等价于解决另一个我们关心的问题,比如求平方根。
在继续之前先说一句感慨:我们很容易把「知道怎么求平方根」当成理所当然。不只是 Python,你的手机、浏览器、口袋计算器都能替你算出来。然而,学习计算机科学的一部分,就是理解这些量是怎么算出来的;而这里介绍的通用方法,适用于求解一大类 Python 内置之外的方程。
牛顿法也是一种迭代改进算法:它会改进对任意可微(differentiable)函数零点的猜测——可微,意味着函数在任意点都能用一条直线近似。牛顿法沿着这些线性近似(linear approximations)一路逼近,从而找到函数的零点。
试想一条穿过点
这条直线的斜率,是函数值变化量与函数自变量变化量之比。所以,把当前
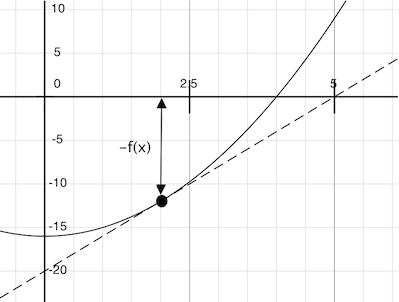
对函数 newton_update 表示沿这条切线逼近到 0 的计算过程。
>>> def newton_update(f, df):
     def update(x):
         return x - f(x) / df(x)
     return update
最后,我们可以用 newton_update、improve 算法,以及一个判断 find_zero:
>>> def find_zero(f, df):
     def near_zero(x):
         return approx_eq(f(x), 0)
return improve(newton_update(f, df), near_zero)计算根。用牛顿法可以计算任意次方根。a 的 n 次方根,就是满足
- 64 的平方根是 8,因为
- 64 的三次方根是 4,因为
- 64 的六次方根是 2,因为
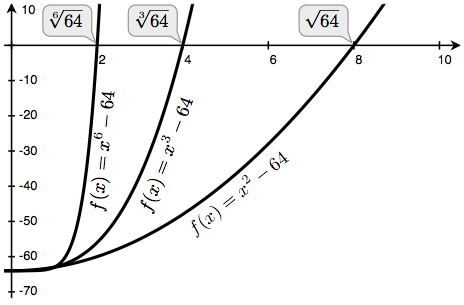
用牛顿法计算根,依据的是下面这些观察:
- 64 的平方根(写作
)是满足 的 的值 - 更一般地,a 的 n 次方根(写作
)是满足 的 的值
只要能找到最后一个方程的零点,就能算出 n 次方根。把 n 取 2、3、6,a 取 64,画出对应的曲线,就能把这种关系可视化。
我们先定义 square_root_newton。由微积分可知,
>>> def square_root_newton(a):
     def f(x):
         return x * x - a
     def df(x):
         return 2 * x
     return find_zero(f, df)

>>> square_root_newton(64)
8.0
推广到 n 次方根,就是计算
>>> def power(x, n):
     """返回 x * x * x * ... * x,n 个 x 相乘"""
     product, k = 1, 0
     while k < n:
         product, k = product * x, k + 1
     return product

>>> def nth_root_of_a(n, a):
     def f(x):
         return power(x, n) - a
     def df(x):
         return n * power(x, n-1)
     return find_zero(f, df)

>>> nth_root_of_a(2, 64)
8.0
>>> nth_root_of_a(3, 64)
4.0
>>> nth_root_of_a(6, 64)
2.0
把 approx_eq 里的 tolerance 调小一些,这些计算中的近似误差就能进一步减小。
使用牛顿法时要注意,它并非总是收敛。improve 的初始猜测必须足够接近零点,而且函数本身也要满足一些条件。尽管有这个局限,牛顿法仍然是求解可微方程的一种强大而通用的计算方法。现代计算机里,对数和大整数除法的高速算法就大量采用了牛顿法及其变种。
1.6.6 柯里化
用高阶函数,可以把一个接受多个参数的函数,变成一串各自只接受单个参数的函数。
具体来说,给定一个函数 f(x, y),我们可以定义一个函数 g,使得 g(x)(y) 等价于 f(x, y)。这里的 g 是一个高阶函数,它接受单个参数 x,并返回另一个接受单个参数 y 的函数。这种转换称为柯里化(currying)。
例如,我们可以定义 pow 的柯里化版本:
>>> def curried_pow(x):
        def h(y):
            return pow(x, y)
        return h
>>> curried_pow(2)(3)
8
有些编程语言(比如 Haskell)只允许单参数函数,所以程序员必须把所有多参数过程都柯里化。在 Python 这类更通用的语言里,当我们需要一个只接受单个参数的函数时,柯里化就很有用。
例如,map 模式就是把一个单参数函数施加到一系列值上。后面的章节会给出 map 模式更通用的例子,现在我们可以先用一个函数把它实现出来:
>>> def map_to_range(start, end, f):
        while start < end:
            print(f(start))
            start = start + 1
我们可以用 map_to_range 和 curried_pow 打印 2 的前十次幂,而不必专门为 2 写一个幂函数:
>>> map_to_range(0, 10, curried_pow(2))
1
2
4
8
16
32
64
128
256
512
同样地,用这两个函数还能计算其他数的幂。柯里化让我们不必为每个底数都写一个专用函数。
上面的例子里,我们手动对 pow 做了柯里化,得到 curried_pow。其实,我们也可以定义函数,把柯里化以及它的逆变换——反柯里化(uncurrying)——自动完成:
>>> def curry2(f):
        """返回给定的双参数函数的柯里化版本"""
        def g(x):
            def h(y):
                return f(x, y)
            return h
        return g
>>> def uncurry2(g):
        """返回给定的柯里化函数的双参数版本"""
        def f(x, y):
            return g(x)(y)
        return f
>>> pow_curried = curry2(pow)
>>> pow_curried(2)(5)
32
>>> map_to_range(0, 10, pow_curried(2))
1
2
4
8
16
32
64
128
256
512
curry2 函数接受一个双参数函数 f,返回一个单参数函数 g。把 g 施加到参数 x 上时,它返回一个单参数函数 h。把 h 施加到 y 上时,它调用 f(x, y)。因此,curry2(f)(x)(y) 等价于 f(x, y)。uncurry2 函数反转柯里化变换,因此 uncurry2(curry2(f)) 等价于 f。
>>> uncurry2(pow_curried)(2, 5)
32
1.6.7 Lambda 表达式
到目前为止,每次我们想定义新函数,都得给它起个名字。但对其他类型的表达式,我们并不需要给中间值命名。
也就是说,我们可以计算 a * b + c * d,而不必给子表达式 a*b 或 c*d,甚至整个表达式命名。
在 Python 里,我们可以用 lambda 表达式实时创建函数(匿名函数)。lambda 表达式求值后得到一个函数,这个函数的函数体只有一个返回表达式,不允许出现赋值或控制语句。
>>> def compose1(f, g):
        return lambda x: f(g(x))
可以对照一个英文句子,来理解 lambda 表达式的结构:
lambda              x         :              f(g(x))
"A function that    takes x   and returns    f(g(x))"
lambda 表达式的结果称为 lambda 函数。它没有内在名称(所以 Python 显示的名字是 <lambda>),但其他行为和普通函数完全一样。
>>> s = lambda x: x * x
>>> s
<function <lambda> at 0xf3f490>
>>> s(12)
144
在环境图里,lambda 表达式的结果也是一个函数,用希腊字母 λ(lambda)标注名字。用 lambda 可以把 compose1 写得非常紧凑:
有些程序员觉得,用 lambda 创建的匿名函数更简洁直接。但复合的 lambda 表达式虽然短,却出了名地难读。比如下面这行虽然正确,但很多程序员都没法一眼看懂:
>>> compose1 = lambda f,g: lambda x: f(g(x))一般来说,Python 的风格更偏好显式的 def 语句,而不是 lambda;但在需要一个简单函数作为参数或返回值时,也允许用 lambda。
这类风格规则只是指导意见,你完全可以按自己的喜好编程。但写代码时,不妨想想将来可能读到你的程序的人——当你能让程序更容易理解时,就是在帮他们的忙。
术语 lambda 其实是个历史意外,源自书面数学符号与早期排版系统限制之间的不兼容。
用 lambda 来引入过程或函数,初看或许有些别扭。这个记号可以追溯到 Alonzo Church:20 世纪 30 年代,他最初用一个「帽子」符号,把平方函数写成「ŷ . y × y」。但排字工人觉得别扭,就把帽子移到参数左边,改成大写 lambda:「Λy . y × y」;后来大写 lambda 又改成小写,于是数学书里出现了「λy . y × y」,Lisp 里则写成
(lambda (y) (* y y))。—— Peter Norvig(norvig.com/lispy2.html)
尽管词源有些奇特,lambda 表达式以及与之对应的函数应用形式语言——λ演算(lambda calculus)——都是计算机科学的基本概念,影响远超 Python 编程社区。等我们在第 3 章研究解释器设计时,会再回到这个话题。
1.6.8 抽象与一等函数
本节开头我们指出,用户自定义函数是一种关键的抽象机制,因为它们让我们能把通用的计算方法作为编程语言中的显式元素表达出来。现在我们又看到,高阶函数让我们能操作这些通用方法,从而创造更进一步的抽象。
作为程序员,我们应该留意识别程序中潜在的底层抽象,在它们之上继续搭建,并把它们泛化,创造出更强大的抽象。这并不是说永远要用最抽象的方式写程序——高手懂得选择与任务相称的抽象层次。但重要的是,我们要能借助这些抽象来思考,这样在新的场景里才能迅速用上它们。
高阶函数的意义在于,它们让我们能把这些抽象显式地表示为编程语言中的元素,像对待其他计算元素一样操作它们。
一般来说,编程语言会对计算元素的操作方式施加各种限制。限制最少的元素,称为具有一等地位(first-class status)。一等元素通常享有以下「权利和特权」:
- 可以绑定到名字
- 可以作为参数传给函数
- 可以作为函数的结果返回
- 可以放进数据结构
Python 赋予函数完整的一等地位,由此带来的表达能力提升是巨大的。
1.6.9 函数装饰器
Python 提供了一种特殊语法,让我们在执行 def 语句时就能施加高阶函数,这种语法称为装饰器(decorator)。最常见的例子之一就是 trace:
>>> def trace(fn):
        def wrapped(x):
            print('-> ', fn, '(', x, ')')
            return fn(x)
        return wrapped

>>> @trace
    def triple(x):
        return 3 * x

>>> triple(12)
->  <function triple at 0x102a39848> ( 12 )
36
这个例子里定义了一个高阶函数 trace,它返回一个函数:在调用自己的参数之前,先用一条 print 语句把这个参数打印出来。
@trace 注解改变了 def 的执行规则:照常先创建 triple 函数,但名字 triple 最终绑定的并不是这个函数,而是对刚定义的 triple 调用 trace 后返回的函数值。等价的非装饰器写法是:
>>> def triple(x):
        return 3 * x
>>> triple = trace(triple)
在本书相关的项目中,装饰器常用来跟踪函数调用,或者在从命令行运行程序时选择要调用哪些函数。
专家扩展。装饰器符号 @ 后面也可以跟一个调用表达式。@ 后面的表达式先求值(就像上面求值名称 trace 那样),接着执行 def,最后把装饰器表达式的结果施加到新定义的函数上,结果绑定到 def 语句里的名字。Ariel Ortiz 写过一篇装饰器简明教程,感兴趣的同学可以看更多例子。