
2.9 递归对象
对象可以把其他对象作为属性值。当某个类的对象有一个属性值也属于同一个类时,它就是一个递归对象。
2.9.1 链表类
链表(linked list)在本章前面已经介绍过,由第一个元素和链表剩余部分两部分组成。链表剩余部分本身又是一个链表——这就是递归定义。空链表是一种特殊情况:它既没有第一个元素,也没有剩余部分。
链表是一种序列(sequence):它有有限的长度,支持按索引选取元素。
现在我们可以实现一个行为相同的类。在这个版本里,我们用特殊方法名(special method name)来定义它的行为,让这个类能与 Python 内置的 len 函数和元素选择操作符(方括号或 operator.getitem)配合使用。这些内置函数会调用类的特殊方法:长度由 __len__ 计算,元素选择由 __getitem__ 计算。空链表用一个空元组表示,它的长度为 0,也不含任何元素。
>>> class Link:
        """一个链表"""
        empty = ()
        def __init__(self, first, rest=()):
            assert rest == Link.empty or isinstance(rest, Link)
            self.first = first
            self.rest = rest
        def __getitem__(self, i):
            if i == 0:
                return self.first
            else:
                return self.rest[i-1]
        def __len__(self):
            return 1 + len(self.rest)
>>> s = Link(3, Link(4, Link(5)))
>>> len(s)
3
>>> s[1]
4
以上的 __len__ 和 __getitem__ 定义其实都是递归的。Python 内置函数 len 作用于用户定义类的实例时,会调用 __len__ 方法。类似地,元素选择操作符会调用 __getitem__ 方法。因此,这两个方法的主体都会间接地调用自己。对 __len__ 来说,基准情况(base case)出现在 self.rest 求值为空元组 Link.empty 时,此时长度为 0。
内置的 isinstance 函数返回第一个参数的类型是否等于第二个参数,或者继承自第二个参数。如果 rest 是 Link 的实例,或者是 Link 某个子类的实例,isinstance(rest, Link) 就为 True。
我们的实现已经完整了,但目前还很难查看 Link 类的实例。为了方便调试,我们可以再定义一个函数,把 Link 转换成字符串表达式。
>>> def link_expression(s):
        """返回一个可以计算得到 s 的字符串表达式。"""
        if s.rest is Link.empty:
            rest = ''
        else:
            rest = ', ' + link_expression(s.rest)
        return 'Link({0}{1})'.format(s.first, rest)
>>> link_expression(s)
'Link(3, Link(4, Link(5)))'
用这种方式显示 Link 实在太方便了,我们希望每次显示 Link 实例时都能用它。只要把 link_expression 函数设为专用类属性 __repr__ 的值,就能实现这个行为。Python 显示用户定义类的实例时,会调用它的 __repr__ 方法。
>>> Link.__repr__ = link_expression
>>> s
Link(3, Link(4, Link(5)))
Link 类具有闭包性质(closure property)。就像列表的元素本身可以是列表一样,Link 的第一个元素也可以是一个 Link。
>>> s_first = Link(s, Link(6))
>>> s_first
Link(Link(3, Link(4, Link(5))), Link(6))
链表 s_first 只有两个元素,但它的第一个元素是一个含三个元素的链表。
>>> len(s_first)
2
>>> len(s_first[0])
3
>>> s_first[0][2]
5
递归函数特别适合操作链表。比如,递归函数 extend_link 构造一个链表,它包含 Link 实例 s 的元素,后面接着另一个 Link 实例 t 的元素。把这个函数装成 Link 类的 __add__ 方法,就能模拟内置列表的加法行为。
>>> def extend_link(s, t):
        if s is Link.empty:
            return t
        else:
            return Link(s.first, extend_link(s.rest, t))
>>> extend_link(s, s)
Link(3, Link(4, Link(5, Link(3, Link(4, Link(5))))))
>>> Link.__add__ = extend_link
>>> s + s
Link(3, Link(4, Link(5, Link(3, Link(4, Link(5))))))
不用列表推导式(list comprehension),我们也能借助两个高阶函数从一个链表生成另一个链表:map_link 和 filter_link。下面定义的 map_link 把函数 f 作用到链表 s 的每个元素上,并构造一个包含这些结果的链表。
>>> def map_link(f, s):
        if s is Link.empty:
            return s
        else:
            return Link(f(s.first), map_link(f, s.rest))
>>> map_link(square, s)
Link(9, Link(16, Link(25)))
filter_link 函数返回一个链表,其中包含链表 s 里所有让 f 返回真值的元素。把 map_link 和 filter_link 组合起来,就能表达和列表推导式相同的逻辑。
>>> def filter_link(f, s):
        if s is Link.empty:
            return s
        else:
            filtered = filter_link(f, s.rest)
            if f(s.first):
                return Link(s.first, filtered)
            else:
                return filtered
>>> odd = lambda x: x % 2 == 1
>>> map_link(square, filter_link(odd, s))
Link(9, Link(25))
>>> [square(x) for x in [3, 4, 5] if odd(x)]
[9, 25]
join_link 函数递归地构造一个字符串,其中包含链表的各个元素,元素之间用分隔字符串 separator 隔开。这个结果比 link_expression 的输出简练得多。
>>> def join_link(s, separator):
        if s is Link.empty:
            return ""
        elif s.rest is Link.empty:
            return str(s.first)
        else:
            return str(s.first) + separator + join_link(s.rest, separator)
>>> join_link(s, ", ")
'3, 4, 5'递归构造(Recursive Construction):当序列需要增量式地构造时,链表特别有用,而这种情况在递归计算中经常出现。
第一章的 count_partitions 函数通过树形递归过程,计算了用最大为 m 的部分分割整数 n 的方法数。有了序列,我们也可以用类似的过程把这些分割显式地枚举出来。
我们沿用计数时对问题的递归分析:用最大为 m 的整数分割 n,有两种情况:
- 用最大为
m的整数分割n-m,或者 - 用最大为
m-1的整数分割n
至于基准情况:0 有一个空分割,而分割负整数、或者用小于 1 的部分,都是不可能的。
>>> def partitions(n, m):
        """返回一个分割 n 的链表,其中每项最大为 m。
        每个分割都表示为一个链表。
        """
        if n == 0:
            return Link(Link.empty) # A list containing the empty partition
        elif n < 0 or m == 0:
            return Link.empty
        else:
            using_m = partitions(n-m, m)
            with_m = map_link(lambda s: Link(m, s), using_m)
            without_m = partitions(n, m-1)
            return with_m + without_m
在递归情况里,我们构造两个分割子列表。第一个用到 m,所以我们在 using_m 结果的每个元素前面加上 m,构成 with_m。
partitions 的结果嵌套很深:它是链表的链表。配合合适的分隔符调用 join_link,我们就能以方便人阅读的方式把这些分割显示出来。
>>> def print_partitions(n, m):
        lists = partitions(n, m)
        strings = map_link(lambda s: join_link(s, " + "), lists)
        print(join_link(strings, "\n"))
>>> print_partitions(6, 4)
4 + 2
4 + 1 + 1
3 + 3
3 + 2 + 1
3 + 1 + 1 + 1
2 + 2 + 2
2 + 2 + 1 + 1
2 + 1 + 1 + 1 + 1
1 + 1 + 1 + 1 + 1 + 1
2.9.2 树类
树也可以用用户定义类的实例来表示,而不是内置序列类型的嵌套实例。树是任何这样的数据结构:它有一个属性,该属性是一个分支序列,而这些分支本身也是树。
内部值。 之前我们定义树时,让所有值都出现在叶子上。在每棵子树的根处定义带内部值的树也很常见。树中的内部值称为 label。下面的 Tree 类表示这样的树:每棵树都有一个分支序列,而这些分支本身也是树。
>>> class Tree:
        def __init__(self, label, branches=()):
            self.label = label
            for branch in branches:
                assert isinstance(branch, Tree)
            self.branches = branches
        def __repr__(self):
            if self.branches:
                return 'Tree({0}, {1})'.format(self.label, repr(self.branches))
            else:
                return 'Tree({0})'.format(repr(self.label))
        def is_leaf(self):
return not self.branches例如,Tree 类可以表示斐波那契数计算函数 fib 的递归实现所对应的表达式树中计算出的值。下面的函数 fib_tree(n) 返回一个 Tree,它以第 n 个斐波那契数作为 label,并在分支中记录所有先前计算过的斐波那契数。
>>> def fib_tree(n):
        if n == 1:
            return Tree(0)
        elif n == 2:
            return Tree(1)
        else:
            left = fib_tree(n-2)
            right = fib_tree(n-1)
            return Tree(left.label + right.label, (left, right))
>>> fib_tree(5)
Tree(3, (Tree(1, (Tree(0), Tree(1))), Tree(2, (Tree(1), Tree(1, (Tree(0), Tree(1)))))))
这样表示的树同样用递归函数处理。例如,我们可以对树的 label 求和。作为基准情况,空分支不含任何 label。
>>> def sum_labels(t):
        """对树的 label 求和,可能得到 None。"""
        return t.label + sum([sum_labels(b) for b in t.branches])
>>> sum_labels(fib_tree(5))
10
我们也可以用 memo 构造斐波那契树:重复的子树只会被记忆化版本的 fib_tree 创建一次,却会作为不同大树的多个分支反复使用。
>>> fib_tree = memo(fib_tree)
>>> big_fib_tree = fib_tree(35)
>>> big_fib_tree.label
5702887
>>> big_fib_tree.branches[0] is big_fib_tree.branches[1].branches[1]
True
>>> sum_labels = memo(sum_labels)
>>> sum_labels(big_fib_tree)
142587180
在这些情况下,记忆化节省的计算时间和内存相当可观。我们只创建了 35 个 Tree 实例,而不是 18,454,929 个。
2.9.3 集合
除了列表、元组和字典,Python 还有第四种内置容器类型:集合(set)。集合字面量沿用了它的数学记法:用大括号把元素括起来。重复的元素在构造集合时会被移除。集合是无序集合,所以打印出来的顺序可能和字面量中的元素顺序不同。
>>> s = {3, 2, 1, 4, 4}
>>> s
{1, 2, 3, 4}
Python 的集合支持多种操作,包括成员测试、长度计算,以及并集和交集这些标准集合运算。
>>> 3 in s
True
>>> len(s)
4
>>> s.union({1, 5})
{1, 2, 3, 4, 5}
>>> s.intersection({6, 5, 4, 3})
{3, 4}
除了 union 和 intersection,Python 的集合还支持其他一些方法。谓词 isdisjoint、issubset 和 issuperset 用于集合之间的比较。集合是可变的,可以用 add、remove、discard 和 pop 一次改动一个元素。还有一些方法支持一次改动多个元素,比如 clear 和 update。到了课程的这个阶段,Python 关于集合的 documentation for sets 应该足够容易理解,可以补全其中的细节。
实现集合。 抽象地说,集合是一组互不相同的对象,支持成员测试、并集、交集和邻接。把一个元素邻接到一个集合上,会返回一个新集合,它包含原集合的所有元素以及这个新元素(前提是新元素与原有元素不同)。并集和交集分别返回出现在其中一个集合或同时出现在两个集合中的元素所组成的集合。和任何数据抽象一样,只要某种集合表示提供了这一组行为,我们就可以自由地在这种表示上实现任何函数。
在本节剩下的部分,我们考虑三种表示各不相同的集合实现方法。我们分析集合运算的增长阶,以此刻画这些不同表示的效率。我们会用到本节前面的 Link 和 Tree 类,它们能为基本集合运算提供简单而优雅的递归解法。
作为无序序列的集合。 表示集合的一种方法是把它表示成一个元素不重复出现的序列。空集合用空序列表示。成员测试会递归地遍历列表。
>>> def empty(s):
        return s is Link.empty
>>> def set_contains(s, v):
        """当且仅当 set s 包含 v 时返回 True。"""
        if empty(s):
            return False
        elif s.first == v:
            return True
        else:
            return set_contains(s.rest, v)
>>> s = Link(4, Link(1, Link(5)))
>>> set_contains(s, 2)
False
>>> set_contains(s, 5)
True
这个 set_contains 实现平均需要
>>> def adjoin_set(s, v):
        """返回一个包含 s 的所有元素和元素 v 的所有元素的集合。"""
        if set_contains(s, v):
            return s
        else:
            return Link(v, s)
>>> t = adjoin_set(s, 2)
>>> t
Link(2, Link(4, Link(1, Link(5))))设计一种表示时,我们应当关心的问题之一就是效率。求两个集合 set1 和 set2 的交集也需要成员测试,但这一次,set1 的每个元素都必须在 set2 中测试是否属于,这导致步骤数呈二次增长,对于大小为 n 的两个集合是
>>> def intersect_set(set1, set2):
        """返回一个集合,包含 set1 和 set2 中的公共元素。"""
        return keep_if_link(set1, lambda v: set_contains(set2, v))
>>> intersect_set(t, apply_to_all_link(s, square))
Link(4, Link(1))求两个集合的并集时,我们必须小心,不要把任何元素包含两次。union_set 函数也需要线性次数的成员测试,整个过程同样包含
>>> def union_set(set1, set2):
        """返回一个集合,包含 set1 和 set2 中的所有元素。"""
        set1_not_set2 = keep_if_link(set1, lambda v: not set_contains(set2, v))
        return extend_link(set1_not_set2, set2)
>>> union_set(t, s)
Link(2, Link(4, Link(1, Link(5))))
作为有序序列的集合。 加快集合运算的一个办法是改变表示,让集合元素按递增顺序排列。要做到这一点,我们需要能比较两个对象、判断哪个更大的办法。在 Python 中,许多不同类型的对象都可以用 < 和 > 操作符比较,但在本例中我们只讨论数字。我们按递增顺序列出元素,来表示一组数字。
排序的一个好处体现在 set_contains 中:检查某个对象是否存在时,我们不再需要扫描整个集合。如果遇到的集合元素比要找的元素大,就知道这个元素不在集合中:
>>> def set_contains(s, v):
        if empty(s) or s.first > v:
            return False
        elif s.first == v:
            return True
        else:
            return set_contains(s.rest, v)
>>> u = Link(1, Link(4, Link(5)))
>>> set_contains(u, 0)
False
>>> set_contains(u, 4)
True
这样能省下多少步?最坏情况下,要找的元素可能是集合中最大的那个,步数就和无序表示一样。另一方面,如果我们查找许多大小不同的元素,可以预料:有时能在列表开头附近就停止搜索,有时仍然要检查列表的大部分。平均而言,我们预计需要检查集合中大约一半的元素。因此,所需的平均步数约为
重新实现 intersect_set,我们能获得更可观的加速。在无序表示中,这个操作需要 set1 的每个元素完整扫描一遍 set2。但有了有序表示,我们可以用更聪明的办法:同时遍历两个集合,跟踪 set1 中的元素 e1 和 set2 中的元素 e2。当 e1 和 e2 相等时,就把这个元素放进交集。
不过,假设 e1 小于 e2。由于 e2 比 set2 剩余的元素都小,我们可以立刻断定:e1 不可能出现在 set2 的剩余部分中,因此不在交集里。于是我们不再需要考虑 e1,把它丢弃,继续处理 set1 的下一个元素。当 e2 < e1 时,用类似的逻辑推进 set2 的元素。函数如下:
>>> def intersect_set(set1, set2):
        if empty(set1) or empty(set2):
            return Link.empty
        else:
            e1, e2 = set1.first, set2.first
            if e1 == e2:
                return Link(e1, intersect_set(set1.rest, set2.rest))
            elif e1 < e2:
                return intersect_set(set1.rest, set2)
            elif e2 < e1:
                return intersect_set(set1, set2.rest)
>>> intersect_set(s, s.rest)
Link(4, Link(5))
为了估计这个过程所需的步数,注意每一步我们都会缩小至少一个集合的大小。因此,所需的步数最多是 set1 和 set2 大小之和,而不是无序表示那样的大小之积。这是
用有序序列表示的集合,邻接和并集也可以在线性时间内计算。这些实现留作练习。
作为二叉搜索树的集合。 把集合元素排成恰好有两个分支的树,能比有序序列做得更好。树根处的 entry 保存集合的一个元素。左分支中的条目包含所有小于根处元素的元素。右分支中的条目包含所有大于根处元素的元素。下图展示了表示集合 {1,3,5,7,9,11} 的一些树。同一个集合可以用许多不同的树来表示。在所有二叉搜索树中,左分支的所有元素都小于根处的条目,右子树的所有元素都大于根处的条目。
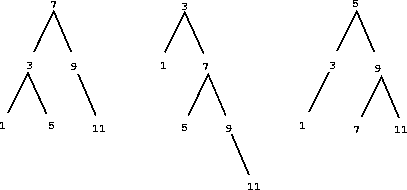
树表示的好处在于:假设我们想检查一个值 v 是否包含在集合中。我们先比较 v 和 entry。如果 v 更小,就知道只需搜索左子树;如果 v 更大,就只需搜索右子树。此时,如果树是「平衡的」,这两个子树的大小都大约是原树的一半。这样,我们一步就把搜索大小为 set_contains 函数就利用了树结构集合的排序结构:
>>> def set_contains(s, v):
        if s is None:
            return False
        elif s.entry == v:
            return True
        elif s.entry < v:
            return set_contains(s.right, v)
        elif s.entry > v:
            return set_contains(s.left, v)
把元素邻接到集合上的实现与搜索类似,也需要 v 与 entry 比较,判断 v 该加到右分支还是左分支;把 v 邻接到合适的分支后,再把这个新构造的分支与原来的 entry 和另一个分支拼接起来。如果 v 等于 entry,就直接返回这个节点。如果要把 v 邻接到一棵空树上,我们就生成一棵树,它的 entry 是 v,左右分支都为空。函数如下:
>>> def adjoin_set(s, v):
        if s is None:
            return Tree(v)
        elif s.entry == v:
            return s
        elif s.entry < v:
            return Tree(s.entry, s.left, adjoin_set(s.right, v))
        elif s.entry > v:
            return Tree(s.entry, adjoin_set(s.left, v), s.right)
>>> adjoin_set(adjoin_set(adjoin_set(None, 2), 3), 1)
Tree(2, Tree(1), Tree(3))
我们说搜索树能在对数步数内完成,前提是树「平衡」,也就是每棵树的左子树和右子树元素数量大致相同,因此每个子树包含大约一半的父树元素。但我们怎么确定构造出的树一定平衡呢?即使从一棵平衡树出发,用 adjoin_set 添加元素也可能产生不平衡的结果。新邻接元素的位置取决于它与集合中已有元素的比较结果,所以可以预料,如果我们「随机」添加元素,树平均而言会趋于平衡。
但这没有保证。例如,从空集合开始,依次邻接数字 1 到 7,最后会得到一棵高度不平衡的树,其中所有左子树都为空,因此它比起简单的有序列表没有任何优势。解决这个问题的一个办法,是定义一个操作,把任意树转换成元素相同的平衡树。我们可以在每进行几次 adjoin_set 操作之后执行一次这种转换,让集合保持平衡。
把树结构集合转换成有序列表再转换回来,就能在线性时间内完成交集和并集操作。具体细节留作练习。
Python 的集合实现。 Python 内置的 set 类型内部并不使用上面任何一种表示。它用的是一种基于哈希(hashing)技术的表示,能提供常数时间的成员测试和邻接操作,这是另一门课程的主题。内置的 Python 集合不能包含可变数据类型,比如列表、字典或其他集合。为了支持嵌套集合,Python 还内置了一个不可变的 frozenset 类,它与 set 类共享方法,但不包含修改方法和操作符。